AI 硬件 / 项目
DaoyuanLi2816/can-i-finetune-this
- 核心运行环境
- Python 3.10–3.14,无需 PyTorch
- 训练运行环境
- Python 3.12、Torch 2.6、bitsandbytes 0.49.2
- 支持方法
- LoRA / QLoRA,序列长度 256–2048 示例
- 已认证平台
- Windows CPU/CUDA、Linux CPU;WSL GPU 未认证
- 1安装核心包$ python -m pip install canifinetune==0.4.1
- 2估算显存预算$ canifinetune estimate --model Qwen/Qwen2.5-1.5B-Instruct --method qlora --gpu-vram-gb 16 --seq-len 2048 --offline
- 3启动本地交互界面$ canifinetune demo
- 4安装训练依赖并加约束$ pip install "canifinetune[train]==0.4.1"
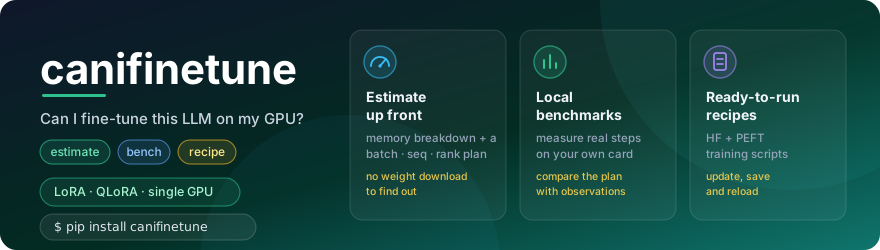
方法、结果与局限
1 / 5
要点
它解决什么问题
单卡消费级 NVIDIA GPU 上训练一个开放权重模型要多少显存,先算再说
- 单卡消费级 NVIDIA GPU 上训练一个开放权重模型要多少显存,先算再说
- 回答该从哪个序列长度、batch size 与 LoRA rank 起步,预算紧张时该改什么
- 把问题转化为显存分解、配置建议和一份可运行配方,而非直接加载权重试错
- 核心估算不依赖 PyTorch,也不需要下载模型权重