AI 研究助理

基于站内最新资料,回答 AI 前沿问题

回答带出处引用,支持多轮追问

快速响应
AI 前沿跟踪
今日首页重点内容GitHub 趋势榜
领域
学术研究
大模型
具身智能
AI 基础设施
智能体 · Skill · MCP
机器人
多模态
自动驾驶
数据 / MLOps
AI 硬件
安全对齐
综述与报告

AI 基础设施

共 49 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 10 分钟前

已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。

全部 49发布 11论文 10模型 0项目 7工具 0数据集 0报告 0博客 21综述 0
细分方向全部推理服务与引擎 32训练框架与并行 5集群、调度与网络 5智能体运行时与沙箱 4可观测与评测平台 0数据与存储管线 1归类中 1
论文AI 基础设施推理服务与引擎3 天前
To Keep or Not to Keep: Learning KV Cache Retention in Disaggregated LLM Serving Systems

KVLearn 学习式 KV 缓存保留:分离式服务 TTFT 最高降 56%,传输量降 53%

分离式推理中缓存决策需权衡重算与网络传输,该框架给出可落地的成本感知方案

KV Cache分离式推理LLM Servingarxiv.org
论文AI 基础设施推理服务与引擎NeurIPS 20265 天前
LoRASpace: A Pool-Wide Shared Substrate for Static and Dynamic Multi-LoRA Composition

LoRASpace:多 LoRA 动态推理快 6x 以上

训练无关地降低多 LoRA 组合推理成本,对 LoRA 池服务有工程参考价值。

LoRA多适配器组合推理加速arxiv.org
博客AI 基础设施集群、调度与网络5 天前
Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster

Meta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型

展示万卡级训练集群在供电、散热与稳定性上的工程实践,对大规模 AI 训练基础设施设计有直接参考价值。

AI基础设施大规模训练超级计算集群engineering.fb.com
论文AI 基础设施推理服务与引擎2 天前
Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

编译 LLM 控制为并行推理,层次 RAG 控制延迟降 35–47%

为层次化 RAG 等结构化控制提供并行化路径,策略精确且延迟下降,对 LLM 推理加速有直接参考价值。

推理加速层次RAG并行推理arxiv.org
发布AI 基础设施推理服务与引擎3 天前
ollama v0.40.8

Ollama v0.40.8 上线 Flint,支持 262K 上下文

Apache 2.0 编码 MoE 模型接入 Ollama,长上下文与多轮工具调用面向代码智能体;当前支持 MacOS。

OllamaFlint长上下文github.com
发布AI 基础设施推理服务与引擎6 天前
sglang v0.5.22

sglang v0.5.22 发布,DeepSeek-V4.1 H200 吞吐提升 2.3x

重要推理框架版本更新,带来多款新模型适配与 H200、B200、B300 等硬件性能优化,对后端部署有直接参考价值。

推理框架模型适配性能优化github.com
博客AI 基础设施集群、调度与网络12 天前
OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks

Meta 在 OCP 2026 发布 102.4T 交换平台与 FPF 网络

Meta 开放液冷机架、交换平台与 scale-out 网络,可供 AI 集群基础设施选型参考。
AI infra网络开源engineering.fb.com
项目AI 基础设施推理服务与引擎4 天前
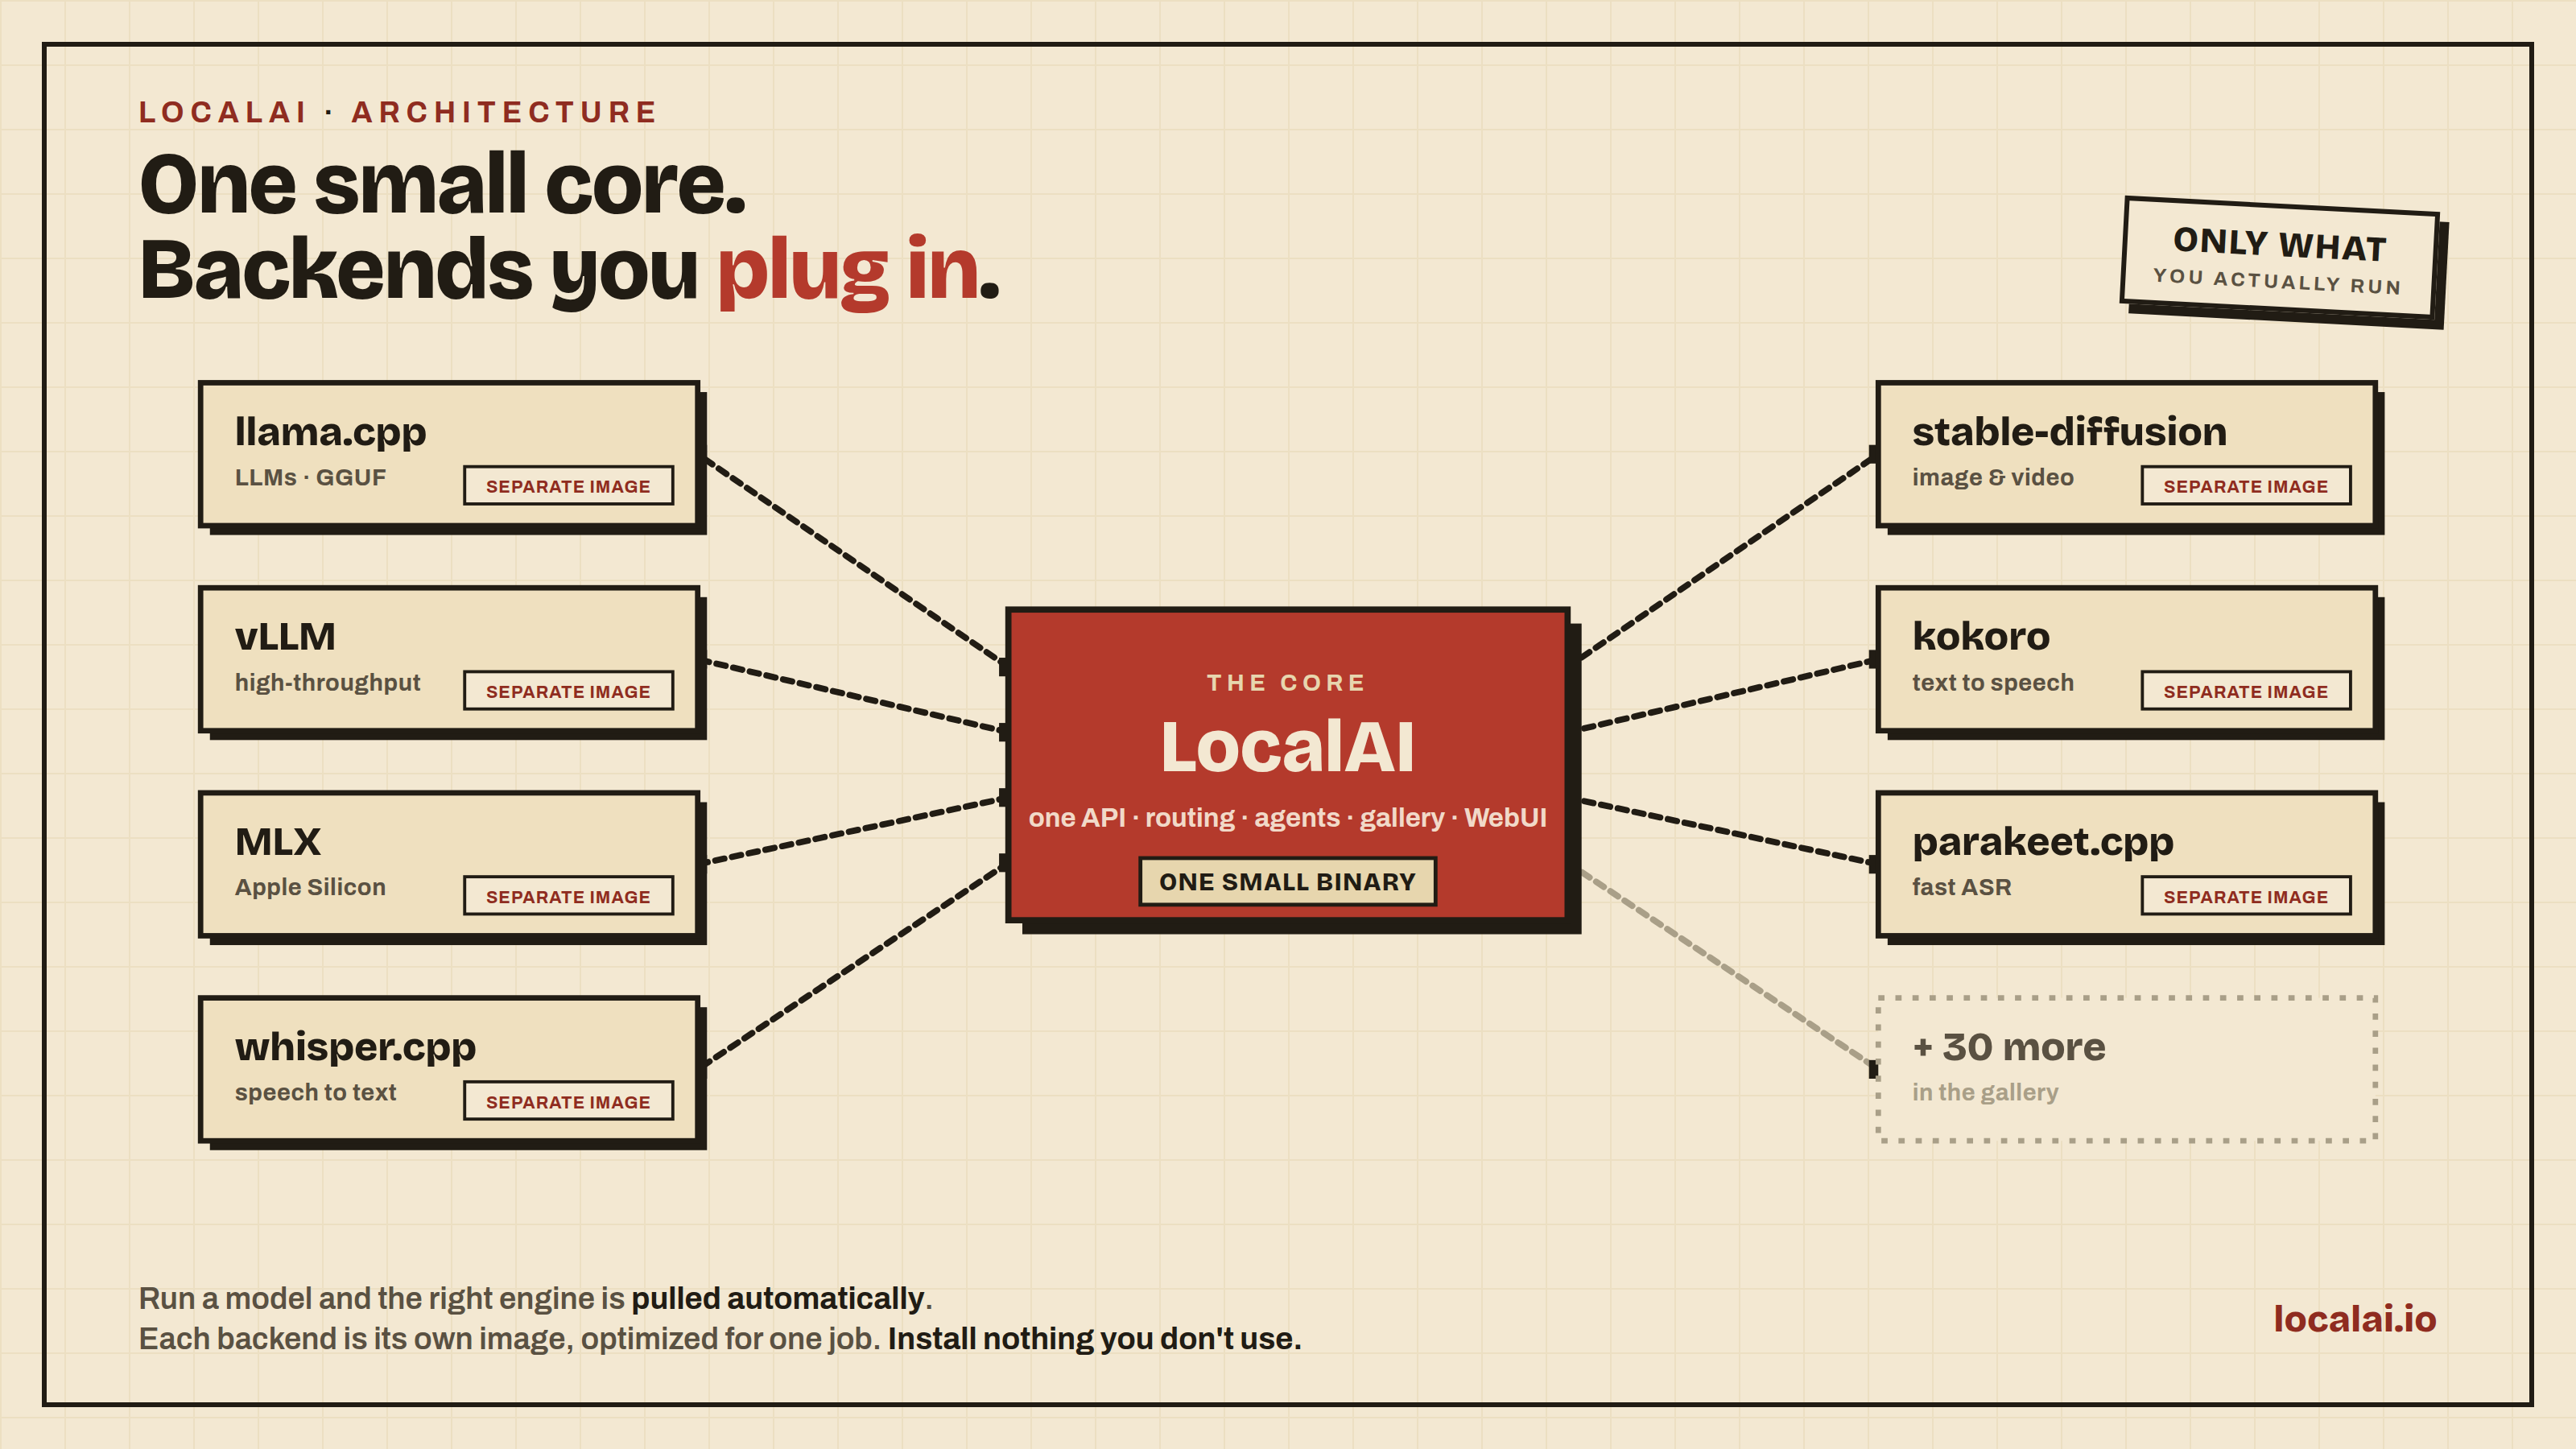
mudler/LocalAI

LocalAI 支持本地运行 LLM/视觉/语音等多模态模型,无需 GPU

为本地/离线/边缘部署多模态模型提供统一开源引擎,显著降低硬件门槛与集成成本
本地推理多模态开源本周 +367github.com
博客AI 基础设施推理服务与引擎5 天前
Improve TTFT for multi-turn agentic workloads with bi-directional KV transfer in vLLM

vLLM 双向 KV 传输:多轮 agent TTFT 最高提速 3.3 倍

针对多轮 agent 反复重算历史上下文的瓶颈,让 decode 节点回传 KV 供 prefill 复用,是 agent 服务降延迟的高价值工程方案。

vLLMKV cacheAgent 推理aws.amazon.com
发布AI 基础设施训练框架与并行1 天前
unsloth MOSS-Image, Flint & NVIDIA Bolt E4B

Unsloth 本地支持 Flint 40B、MOSS-Image 5.1B 和 Nemotron Bolt E4B

为本地推理与微调提供新编码智能体、图像模型和 MoE 剪枝能力;Nemotron E4B 在 Tau2-Bench 从 38.7 提升至 63.2。

UnslothMoE本地推理github.com
发布AI 基础设施推理服务与引擎3 天前
ollama v0.40.9

Ollama v0.40.9 新增 Phonon 语音与 d3 决策模型

Ollama 增加语音输出端点与决策模型,便于应用集成语音和分类/评分能力。

Ollama语音生成决策模型github.com
论文AI 基础设施推理服务与引擎3 天前
HAWK: Heterogeneity-Aware KV Cache Transfer for Efficient GPU-NPU Phase-Disaggregated LLM Inference

HAWK 实现 GPU-NPU 分离式推理的 KV cache 跨设备直传,成本效率达 1.72×

prefill/decode 分置 GPU/NPU 可显著提升能效与成本效率,为异构推理集群设计提供可参考的工程方案。

KV cache异构推理RDMAarxiv.org
第 1 / 4 页 · 共 47 条
1 / 4
1234
← → 键翻页