项目AI 基础设施本地推理多模态开源模型部署
mudler/LocalAI
AI 解读已生成 · AI 生成,数字以原文为准
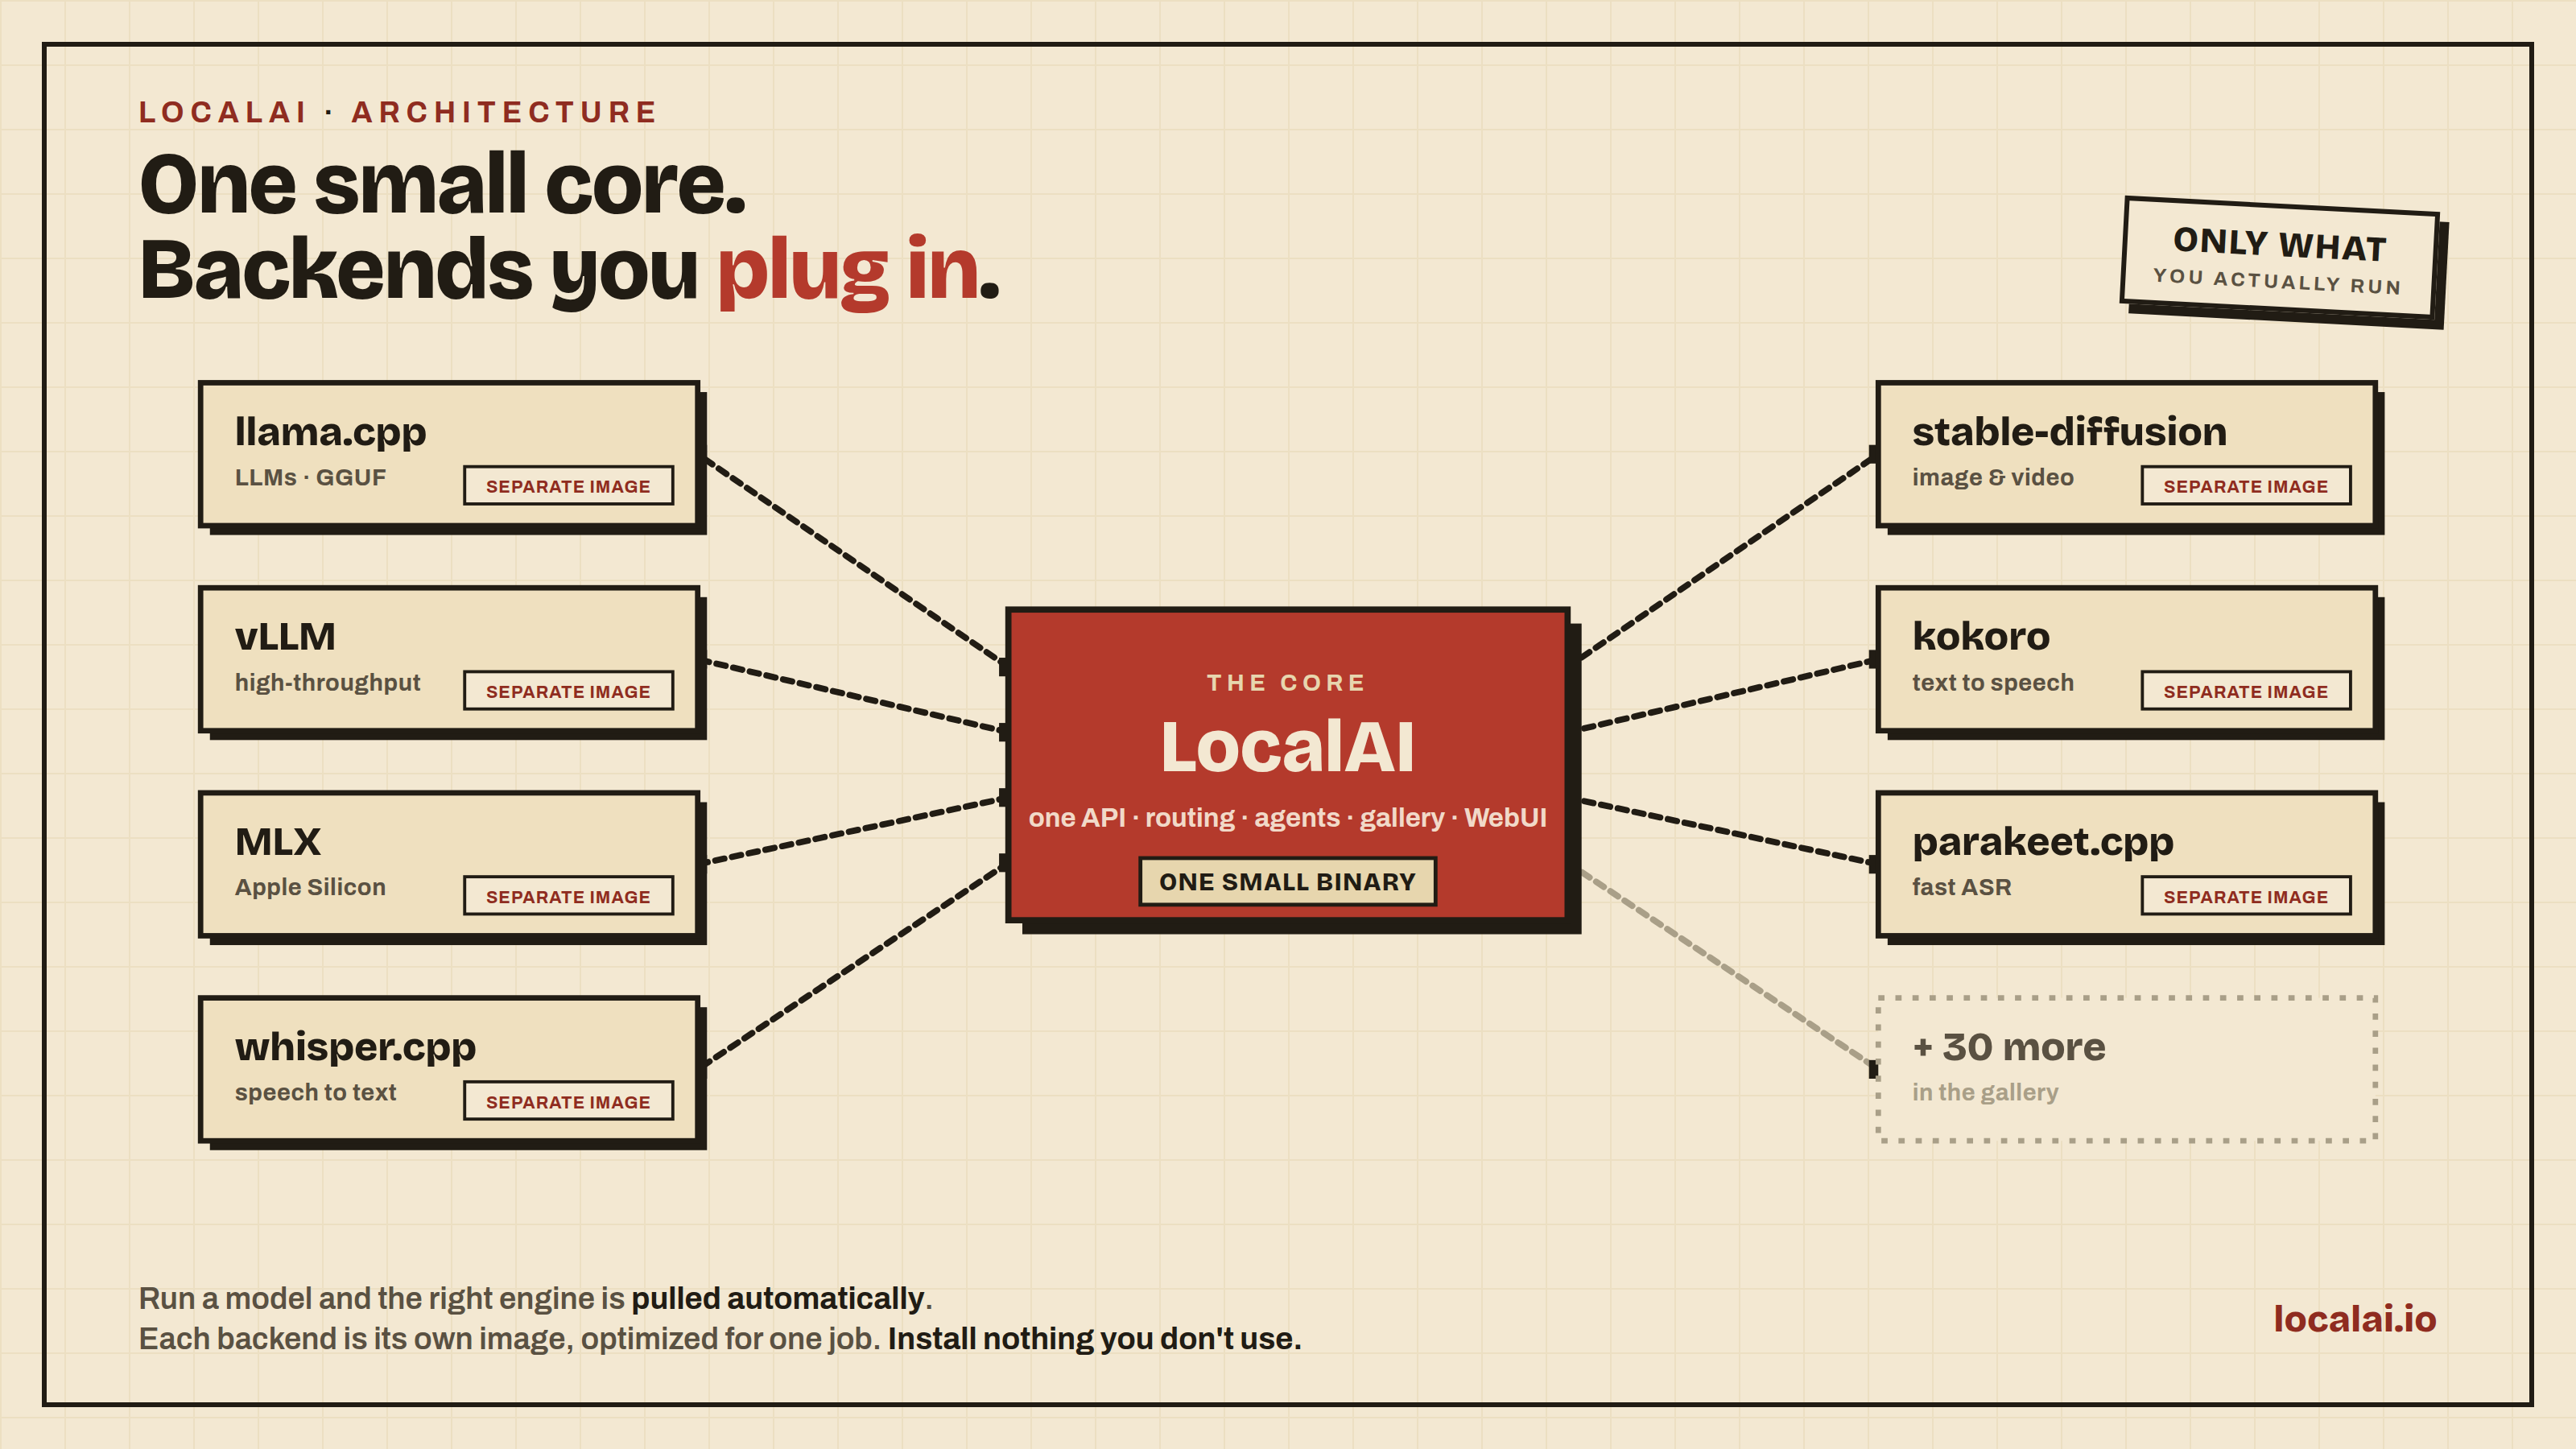
LocalAI v4.11.0 将 60+ 后端拆成按需 OCI 镜像,本地跑多模态 API
LocalAI 是开源 AI 引擎,支持 NVIDIA、AMD、Intel、Apple Silicon、Vulkan 及纯 CPU,本地运行 LLM、视觉、语音、图像、视频模型,无需 GPU。核心为小核心加按需拉取的后端镜像,封装 llama.cpp、vLLM、whisper.cpp 等引擎,提供 OpenAI、Anthropic、ElevenLabs 兼容 API 与多用户配额。可通过 Docker 镜像或 macOS DMG(未签名需去除隔离属性)部署,用 local-ai run 从模型画廊、Huggingface、Ollama、OCI 加载模型,另有 Fyne 启动器和 kong CLI。项目已到 4.11.0,支持 60+ 后端,含 vllm.cpp、parakeet.cpp、face-detect.cpp 等自研 C++/GGML 引擎,以及分布式模式、内置 Agents、Realtime API;vllm.cpp 为 alpha,macOS DMG 未签名。
- 1小核心不捆绑,后端按需拉取
- 2兼容 OpenAI/Anthropic/ElevenLabs 三套 API
- 3v4.11 新增 Decisions API 与故障转移链
为什么重要 对推理基础设施读者:一条 docker run 即可拉起 OpenAI 兼容 API,后端按需拉取,省掉全家桶安装;自研 GGML 引擎无 Python 依赖。适合 需要快速搭建本地推理 API 的 AI 工程/平台团队
- 来源
- github.com
- 发布
- 2026/10/21
- 作者
- mudler
语言占比
- Go 67.6%
- JavaScript 16.4%
- C++ 3.7%
- Python 3.6%
- HTML 2.9%
- CSS 2.6%
- 端口
- 8080
- GUI 框架
- Fyne
- CLI 框架
- kong
60+
支持后端
67.6%
主语言 Go
v4.11.0
当前版本
注释 · Go 占比来自平台统计,后端数与版本来自 README。出自 README·Features
- backend/1192 个文件
后端引擎封装与按需分发
- launcher/
macOS/Linux 桌面启动器
- local-ai/
CLI 主入口,环境变量与命令解析
- configuration/
配置管理
- core/2736 个文件
核心编排与运行时逻辑
- pkg/415 个文件
公共库与工具
- swagger/
API 规范定义
代码分布(各目录文件数)
- core/2736 个
- backend/1192 个
- pkg/415 个
- addons/363 个
- docs/204 个
- tests/159 个
- gallery/97 个
- website/81 个
- scripts/42 个
- (根目录文件)31 个
- 1CPU 启动容器$ docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
- 2NVIDIA CUDA 13 启动$ docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
- 3加载 Gallery 模型$ local-ai run llama-3.2-1b-instruct:q4_k_m
- 4从 HuggingFace 加载$ local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
- 5终端对话$ local-ai chat --model llama-3.2-1b-instruct:q4_k_m
深度总结
1 / 7自建 C/C++/GGML 引擎代表· 表格
vllm.cpp 从零用 C++20 移植 vLLM,带 paged KV、连续批处理与前缀缓存
| 后端 | 功能 |
|---|---|
| vllm.cpp | C++20 移植 vLLM:paged KV、连续批处理、前缀缓存 |
| parakeet.cpp | NVIDIA NeMo Parakeet ASR,缓存感知流式转录 |
| free-splatter.cpp | 照片转 3D 高斯,免相机位姿免 GPU |
| depth-anything.cpp | 单目度量深度 + 相机姿态估计 |
| voice-detect.cpp | 说话人识别与声纹(ECAPA-TDNN、WeSpeaker 等) |
| privacy-filter.cpp | GGML PII/NER 过滤引擎,驱动 PII 脱敏层 |
注释 · README 列出多个原生引擎,这里摘选覆盖文本、语音、视觉与 3D 的 6 个。出自 README·Backends built by us