AI 研究助理

基于站内最新资料,回答 AI 前沿问题

回答带出处引用,支持多轮追问

快速响应
AI 前沿跟踪
今日首页重点内容GitHub 趋势榜
领域
学术研究
大模型
具身智能
AI 基础设施
智能体 · Skill · MCP
机器人
多模态
自动驾驶
数据 / MLOps
AI 硬件
安全对齐
综述与报告

AI 硬件

共 46 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 7 分钟前

已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。

全部 46发布 0论文 15模型 0项目 10工具 0数据集 0报告 0博客 21综述 0
细分方向全部GPU 与加速器 2芯片架构与设计 5内存、互联与网络 4端侧与边缘设备 6编译器与内核优化 7产业与供应链 5
项目AI 硬件重点5 天前
mw00/project-maya

Project Maya 支持私有部署 321B/748B MoE 大模型

降低超大 MoE 私有化门槛,打通 NVIDIA/AMD 与量化部署,可评估本地推理价值。

大模型推理MoE私有部署1.8kgithub.com
论文AI 硬件重点6 天前
Understanding KV Residency in Production-Scale Agentic LLM Workloads

微软 1.21 亿次调用追踪:Deep Research 上下文中位数涨到 68K,80% 走前缀缓存

给出生产级 Agent 负载的 KV 驻留真实分布,直接支撑 HBM 容量规划、前缀缓存命中率优化与调度策略设计

KV Cache前缀缓存Agentarxiv.org
论文AI 硬件编译器与内核优化5 天前
Conjugate Compilation: Self-Improving Agentic Co-Compilation for Speculative Decoding

Conjugate Compilation:投机解码的跨模型联合编译优化

将draft与target模型纳入同一编译优化边界并以实测共同执行性能作反馈,可直接提升现网投机解码吞吐

投机解码推理加速编译器arxiv.org
论文AI 硬件5 天前
MOSAIC: Multi-Objective Search for Allocating Inference Cache Across LLM Decoder Layers

MOSAIC为每层KV缓存学习预算,最高以4倍更少缓存达均匀分配效果

逐层KV预算可即插即用于多种驱逐方法,帮助长上下文服务以更少显存保持任务分数。

KV cache长上下文NASarxiv.org
论文AI 硬件6 天前
On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction

SPOT 用 0.62M 参数模型预测提交顺序,为扩散语言模型实现无损加速

扩散 LM 并行解码的速度-质量权衡是关键瓶颈;把“生成哪个位置”单列为可学习子问题,且小模型+目标模型验证即可无损提速,对推理工程可直接复用。

扩散语言模型投机解码推理加速arxiv.org
论文AI 硬件芯片架构与设计4 天前
Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models

提出多目标 RL 生成 Pareto 最优 RTL 电路,相对 Hypervolume 提升 +13.3 与 +14.4 个百分点

让 LLM 生成 RTL 电路不只优化单一质量,而是优化整组候选的 Pareto 质量与多样性,供设计者按功耗/性能/面积需求事后选择。

RLVRRTL 代码生成多目标优化arxiv.org
博客AI 硬件编译器与内核优化2 天前
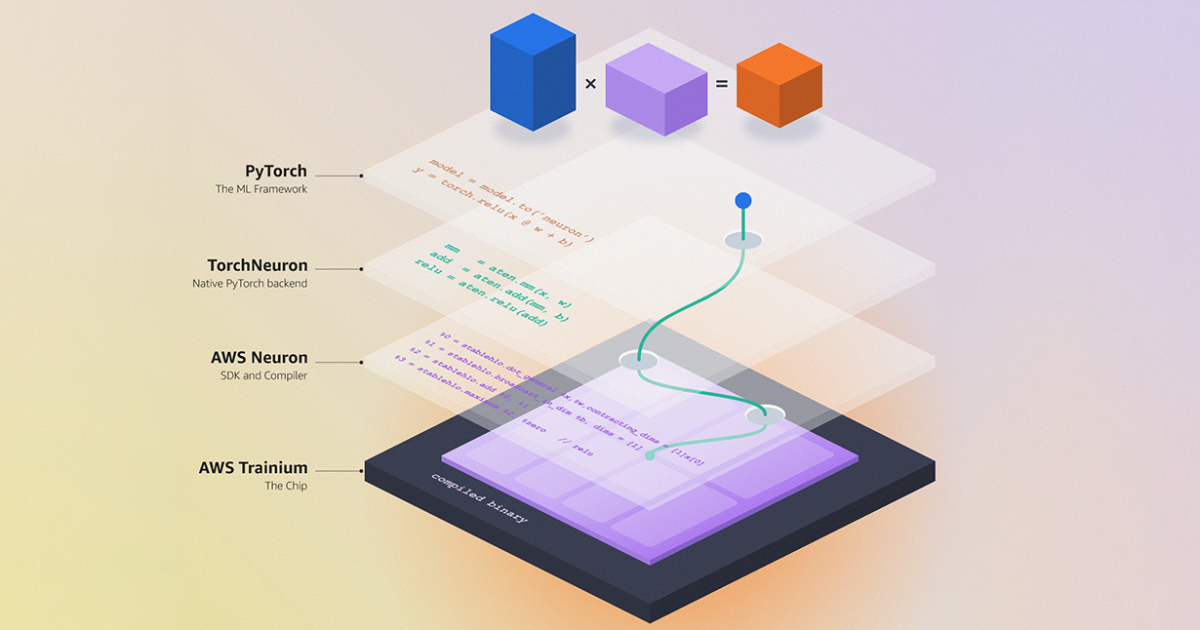
The science behind TorchNeuron, Amazon’s new PyTorch backend for AWS Trainium chips

Amazon 开源 TorchNeuron:PyTorch 代码近乎零改动即可运行于 Trainium

降低 PyTorch 训练负载迁移 Trainium 的门槛,Neuron SDK 提供周期级 profiler 与 NKI 近汇编级内核控制。
同一事件 · 另有 1 个来源报道▾
  • 博客TorchNeuron: running HF models on AWS Trainium is easier than everhuggingface.co
PyTorchTrainium开源amazon.science
博客AI 硬件内存、互联与网络5 天前
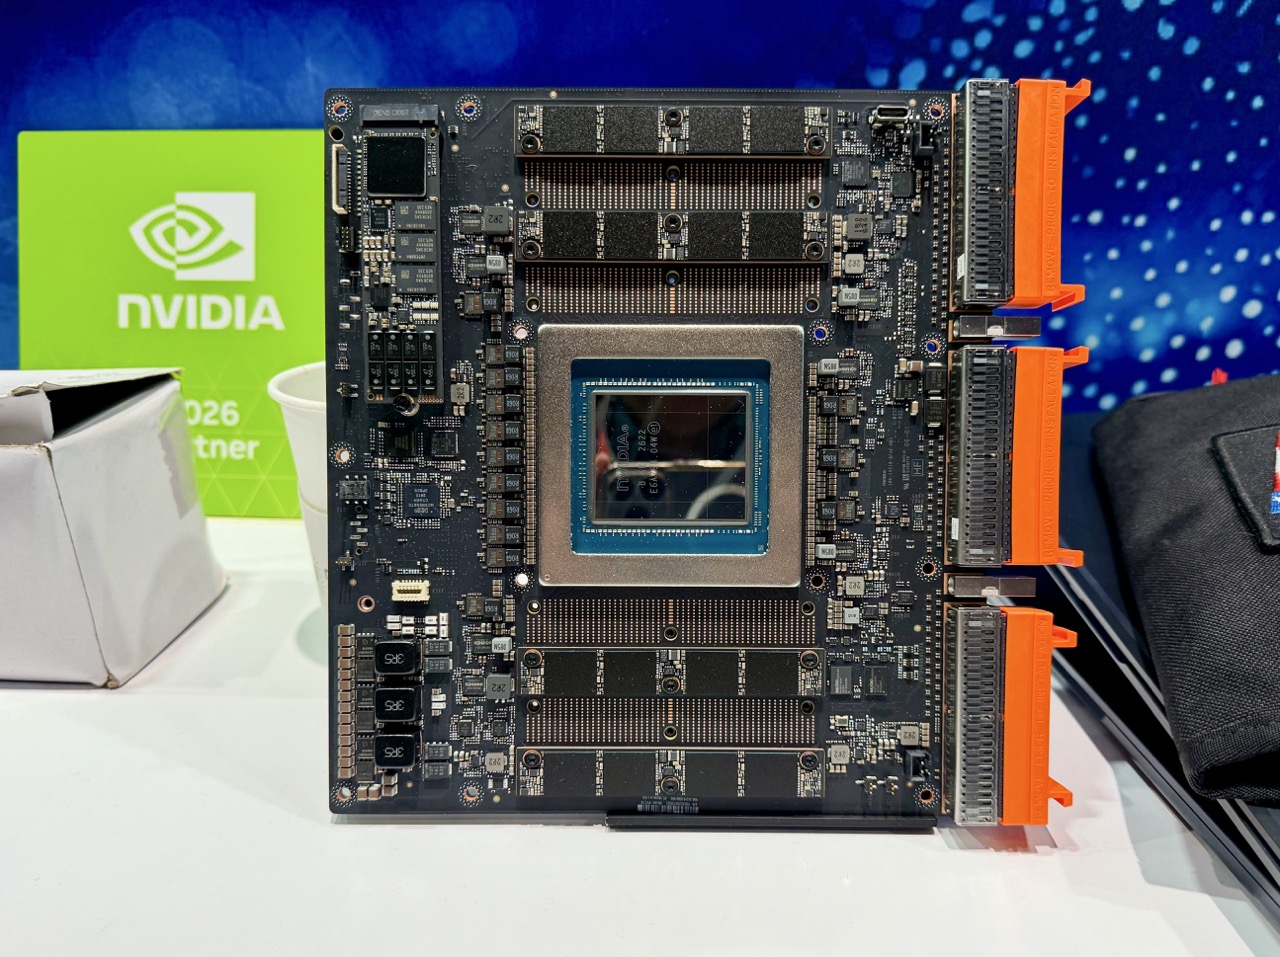
NVIDIA BlueField-4 STX Server for CMX at OCP 2026

NVIDIA OCP展示BlueField-4 CMX服务器

面向上下文内存的DPU/服务器方案,或影响长上下文推理基础设施。
AI硬件DPU长上下文servethehome.com
博客AI 硬件内存、互联与网络5 天前
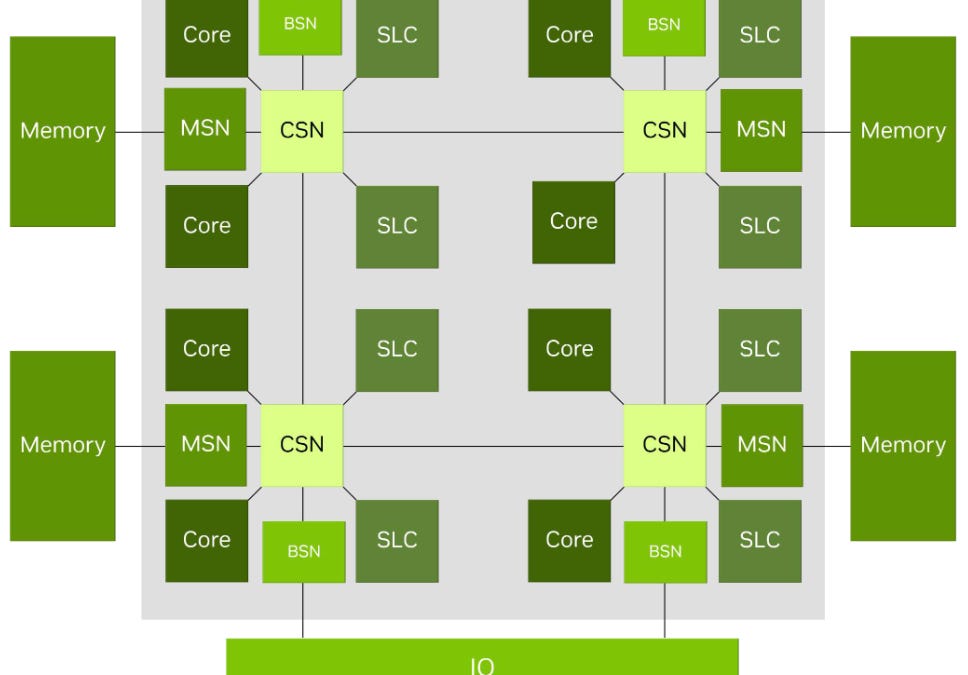
Nvidia Vera’s System Architecture: Pushing Bandwidth

Nvidia Vera用第二代SCF和LPDDR5X提升带宽

解释Vera核心、互连和内存路径,影响AI服务器推理与数据吞吐评估。
AI硬件互连内存带宽chipsandcheese.com
博客AI 硬件编译器与内核优化29 天前
A kernel-centric path to real-time video generation on Trainium

AWS Trainium 实时视频生成 kernel 方案

自回归 diffusion 动态形状与缓存优化可迁移,利好端侧/云端实时生成。
推理加速Trainium视频生成amazon.science
论文AI 硬件芯片架构与设计2 天前
FIGFLEX: A Mixed-Precision FP-INT GEMM Accelerator Co-Designed with Low-Bit LLM Quantization

FIGFLEX 在 LLaMA-2-7B 上 3-bit 困惑度 5.85,吞吐/面积高 1.56x

针对低比特量化“省内存不省计算”问题,算法-硬件协同设计提升了精度灵活性与吞吐,对 LLM 推理硬件设计有参考价值。

FP-INT混合精度LLM 量化arxiv.org
项目AI 硬件5 天前
AmmarkoV/SAM3DBody-cpp

单摄实时3D全身重建C++引擎输出多人体BVH

为端侧/实时数字人、动作捕捉提供纯C++推理路径,便于集成。
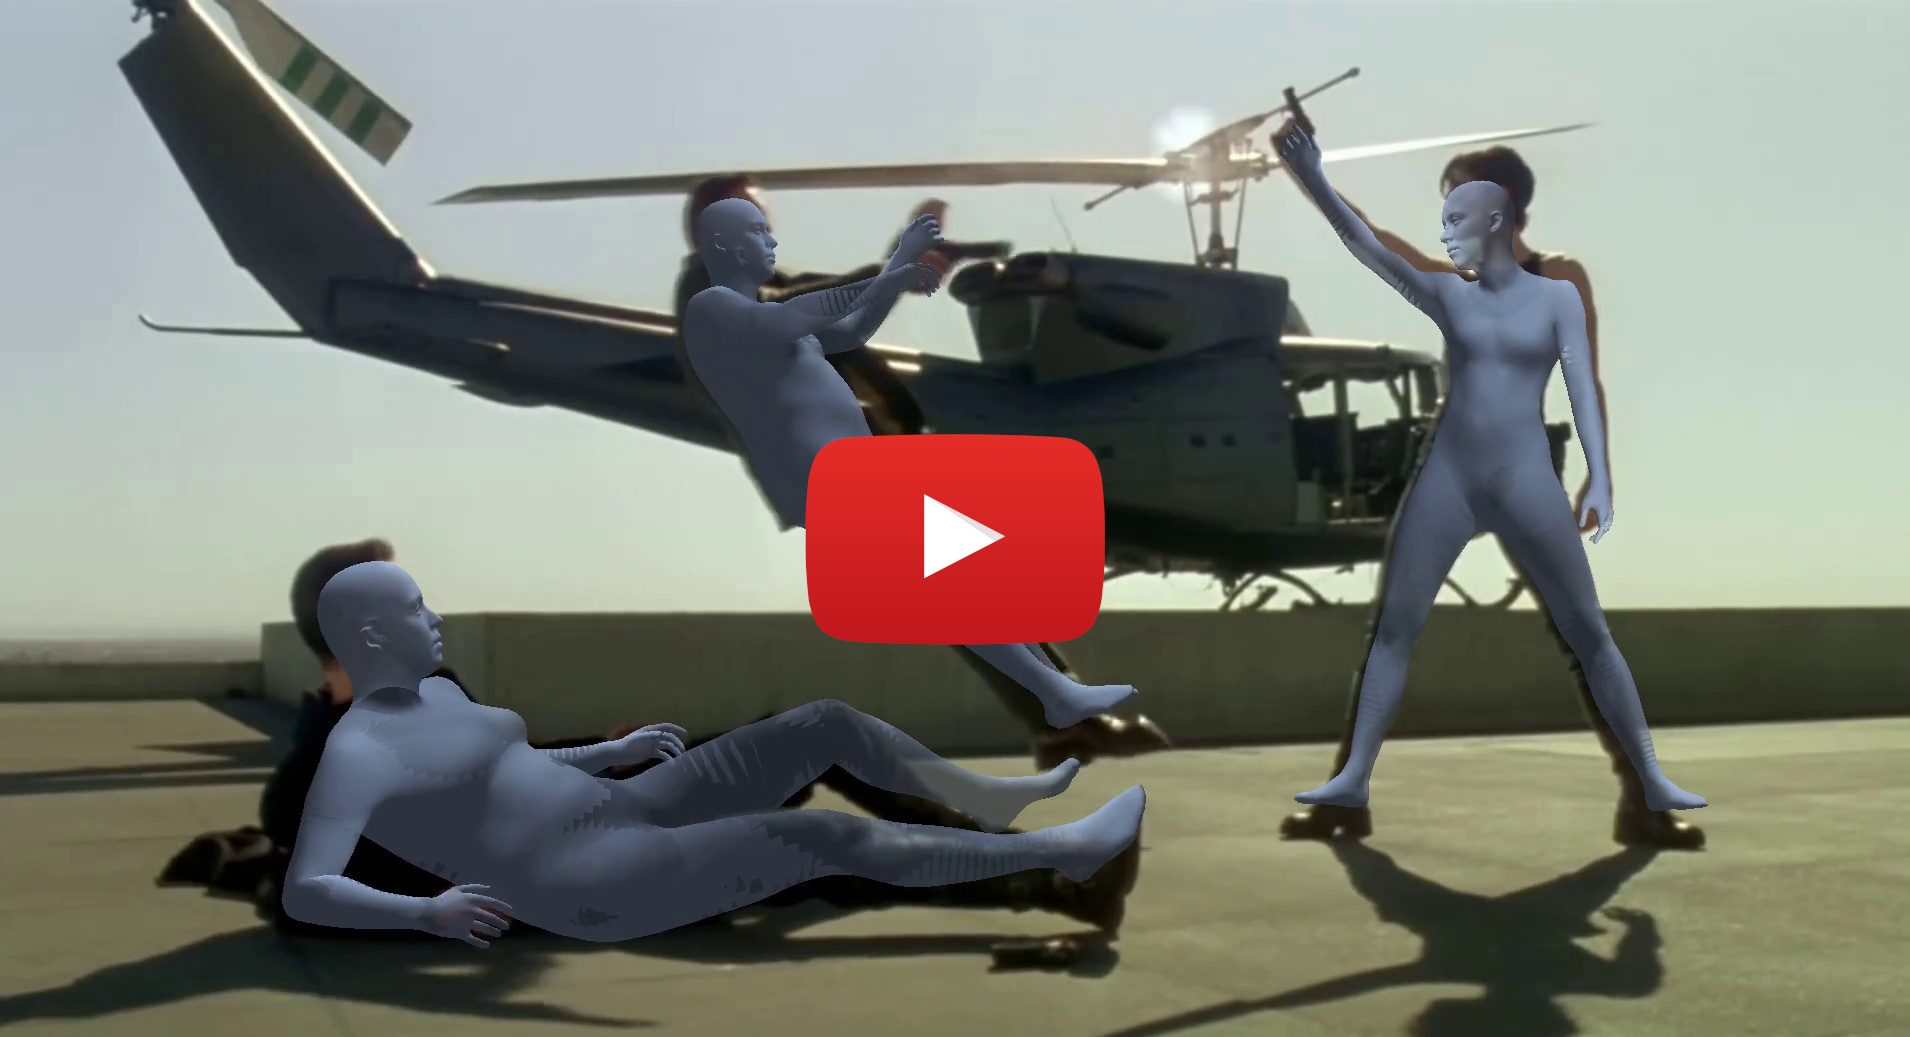
3D重建实时推理C++693github.com
第 1 / 4 页 · 共 37 条
1 / 4
1234
← → 键翻页