AI 硬件 / 博客
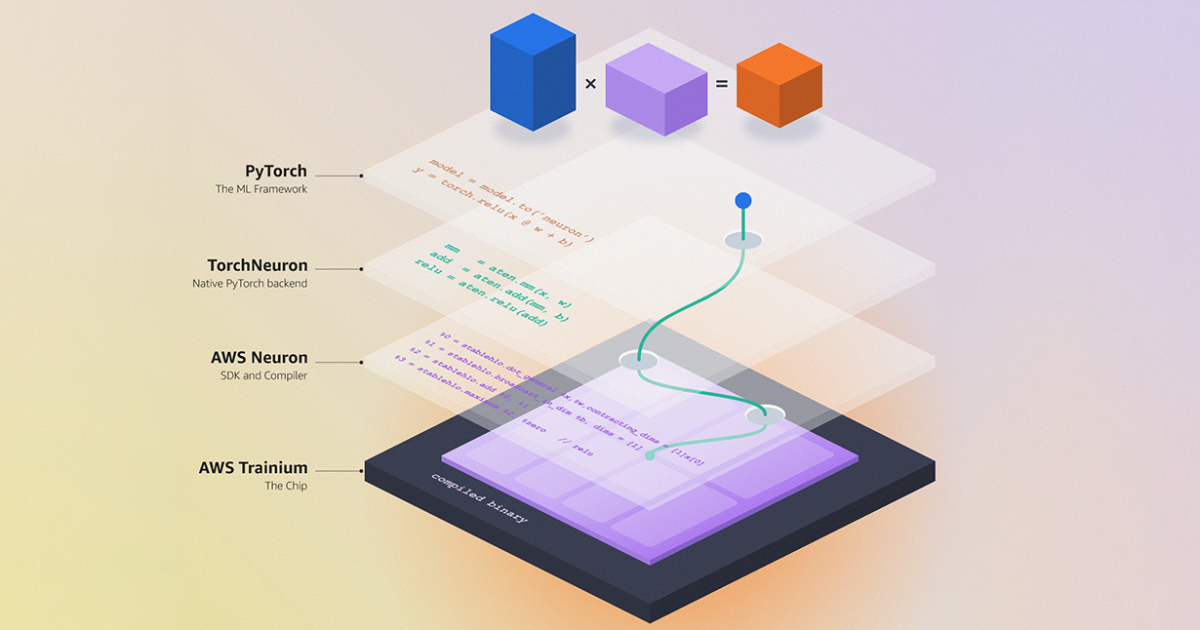
The science behind TorchNeuron, Amazon’s new PyTorch backend for AWS Trainium chips
841
代表模型
覆盖架构特征
16-144
芯片数量
单 UltraServer
4servers
服务器数
最多 Graviton
a third
首步耗时
官方称缩短
注释 · 数字来自跨加速器 LLM 测试出自 Key takeaways
- 发布日期
- 2026-10-22
- 目标硬件
- AWS Trainium
- 默认编译
- AOT by default
- 主机配置
- 最多 4 台 Graviton
方法、结果与局限
1 / 8
判断
迁移后端的核心主张
术语解释Amazon 开源的 PyTorch backend,把 PyTorch 代码转译为 Trainium 可执行操作。 让 PyTorch 低改动进入 Trainium
判断
Amazon 将 术语解释Amazon 开源的 PyTorch backend,把 PyTorch 代码转译为 Trainium 可执行操作。 定位为 PyTorch 到 Trainium 的开源迁移后端,真正看点是用 agent 从海量模型中筛出评测集,并用缓存、共享编译和 术语解释介于 eager 与 compiled 之间的 opt-in 模式,编译小图并与执行重叠。 降低迁移与启动成本。适合评估 Trainium 的团队,但应复测自有负载。
注释 · 官方称开箱即用,实际收益需按负载验证出自 正文开头