Three Physical Walls Are Hitting AI Datacenter Infrastructure at the Same Time - And the Compound Effects Are Worse三堵物理墙同时冲击 AI 数据中心基础设施,复合效应更糟
三堵物理墙同时冲击 AI 数据中心基础设施,复合效应更糟
信息不足,影响待观察
资料 38 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 2 小时前
三堵物理墙同时冲击 AI 数据中心基础设施,复合效应更糟
信息不足,影响待观察
JetPack 7.2.1 新增 Agentic Video Skills
面向 Jetson 多摄像头视频与 AI 推理链路,为机器人视频处理提供智能体化能力,但具体细节有限。

Code-Amadeus/Amadeus
信息不足,影响待观察
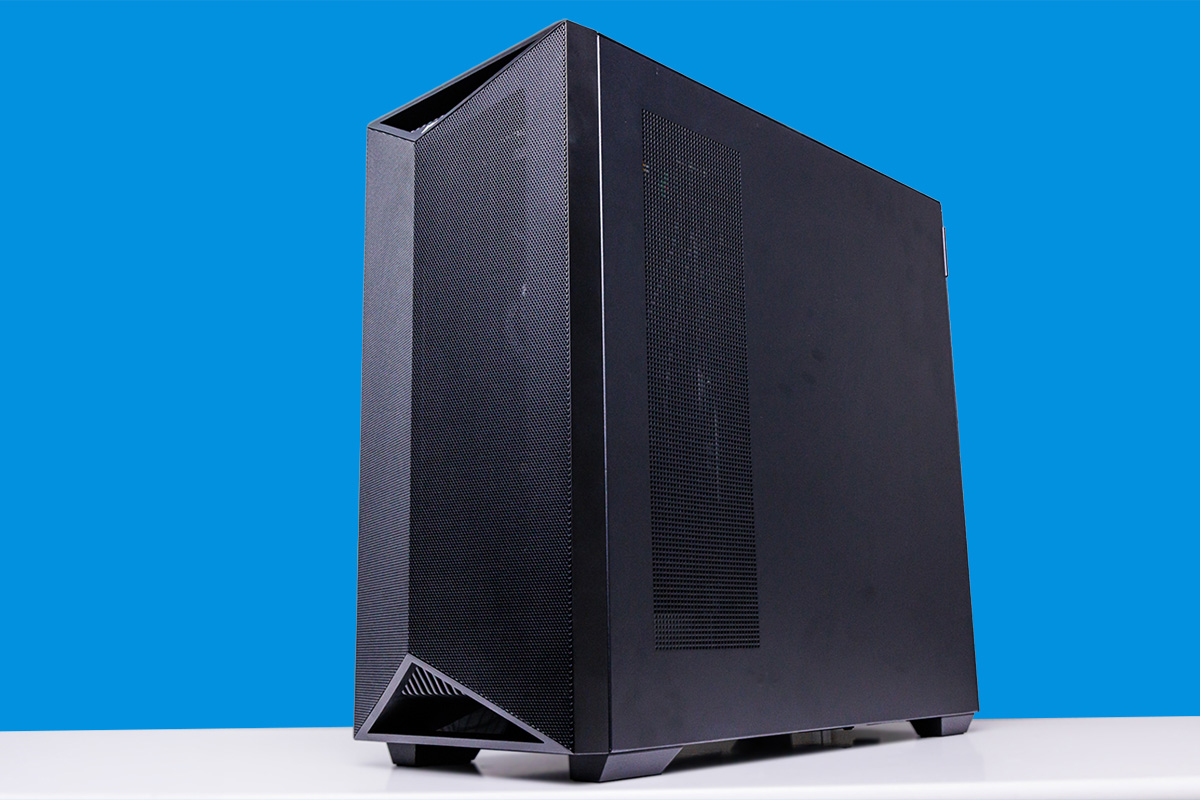
MSI XpertStation WS300 评测:NVIDIA DGX Station 本地 AI 方案
信息不足,影响待观察;仅提供产品评测简介,未涉及具体性能或工程细节。
Glyd实现无损AI压缩:GPU显存减少33%,逐位一致
信息不足,影响待观察
2:4 稀疏 vs 量化:低精度可用时 2:4 更差;H100 FP8 prefill +27%
给出明确部署决策:有更低精度就优先量化;2:4 增益需重训练找回,且恢复 ppl 早于推理能力

KVCompass:面向互联网级前缀缓存共享的发现平面,突破单集群 KV 复用
跨区域复用 KV 可直接降低 prefill 成本与 TTFT,但 KV 持有者集合动态变化,发现机制不能照搬 DHT

Koi:用RLM层级自校准规划多云异构LLM推理集群
把约140个部署变量纳入因果图并依实测反馈自校准,为跨云选型与容量规划提供可评估的自动化思路

LEAF 用 LUT 感知训练在 FPGA 实现纳秒级 Attention
为超低延迟实时场景提供 FPGA 原生 Transformer 推理路线,值得评估硬件加速与边缘部署。
StreamAhead:自适应预计算实现低延迟流式视频问答
在视频到达时预计算与查询时计算之间动态权衡KV缓存,为实时VLM服务提供算法-系统协同设计参考

BS-Spec:BFP 位共享自推测解码,免去独立 draft 模型与 KV cache
把自推测解码与混合精度硬件执行打通,直接指向 LLM servings 吞吐与显存占用,值得评估

共享DRAM的GPU+近存处理架构优化prefill-decode分离
针对PD分离中预填充带宽闲置、解码算力闲置的错配,探索GPU与PNM协同提升利用率。
