Conjugate Compilation: Self-Improving Agentic Co-Compilation for Speculative DecodingConjugate Compilation:投机解码的跨模型联合编译优化
Conjugate Compilation:投机解码的跨模型联合编译优化
将draft与target模型纳入同一编译优化边界并以实测共同执行性能作反馈,可直接提升现网投机解码吞吐

资料 38 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 9 分钟前
Conjugate Compilation:投机解码的跨模型联合编译优化
将draft与target模型纳入同一编译优化边界并以实测共同执行性能作反馈,可直接提升现网投机解码吞吐
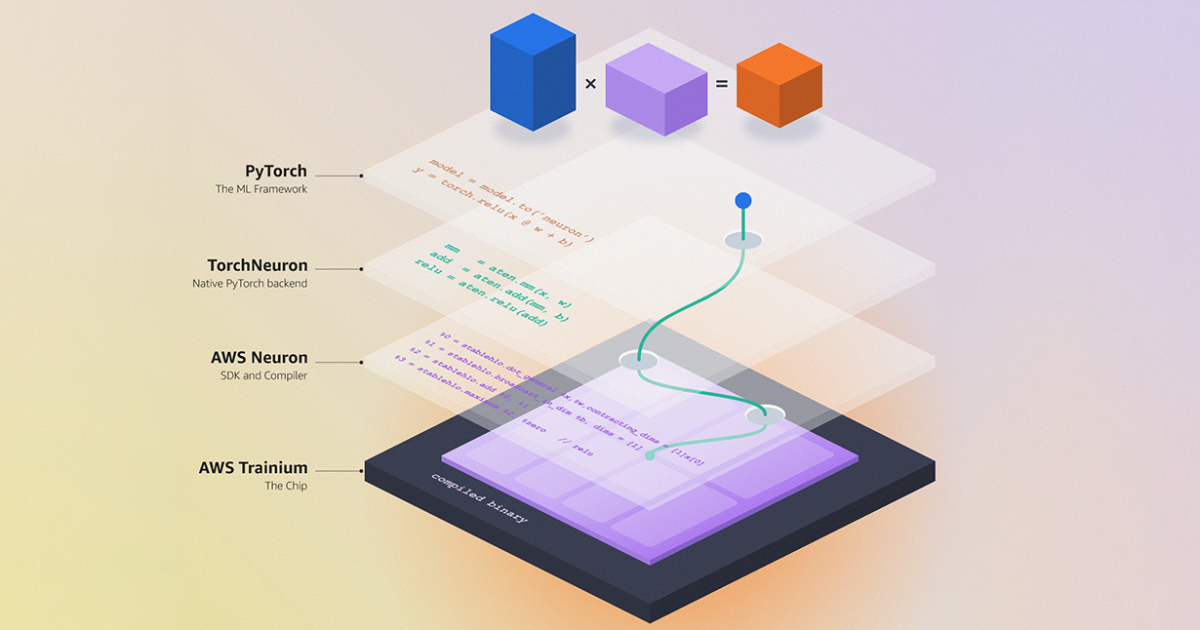
Amazon 开源 TorchNeuron:PyTorch 代码近乎零改动即可运行于 Trainium
降低 PyTorch 训练负载迁移 Trainium 的门槛,Neuron SDK 提供周期级 profiler 与 NKI 近汇编级内核控制。
2:4 稀疏 vs 量化:低精度可用时 2:4 更差;H100 FP8 prefill +27%
给出明确部署决策:有更低精度就优先量化;2:4 增益需重训练找回,且恢复 ppl 早于推理能力

AWS Trainium 实时视频生成 kernel 方案
自回归 diffusion 动态形状与缓存优化可迁移,利好端侧/云端实时生成。
PolyGraph 用单张 CUDA Graph 支撑自适应投机解码,替代 64 张形状专用图
自适应投机解码动态改变验证宽度会迫使服务系统预捕获大量形状;该方案只需 28 字节更新即可复用单图,对推理引擎图捕获策略有直接参考价值
NVIDIA 用 CUDA Tile Python DSL 编写 Mamba-2 前向高性能 kernel
展示用 Python 级 tile DSL 写 SSM kernel 的路径,对自研算子与 Mamba 推理优化有参考价值
K-Search 将数十年 CUDA 内核经验迁移到 MLX
面向 Apple Silicon 的 AI kernel 移植提供自动搜索与优化迁移思路,降低 CUDA 生态经验复用成本。
