AI 研究助理

基于站内最新资料,回答 AI 前沿问题

回答带出处引用,支持多轮追问

快速响应
AI 前沿跟踪
今日首页重点内容GitHub 趋势榜
领域
学术研究
大模型
具身智能
AI 基础设施
智能体 · Skill · MCP
机器人
多模态
自动驾驶
数据 / MLOps
AI 硬件
安全对齐
综述与报告

AI 硬件

共 46 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 25 分钟前

已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。

全部 46发布 0论文 15模型 0项目 10工具 0数据集 0报告 0博客 21综述 0
细分方向全部GPU 与加速器 2芯片架构与设计 1内存、互联与网络 4端侧与边缘设备 4编译器与内核优化 4产业与供应链 5
博客AI 硬件编译器与内核优化2 天前
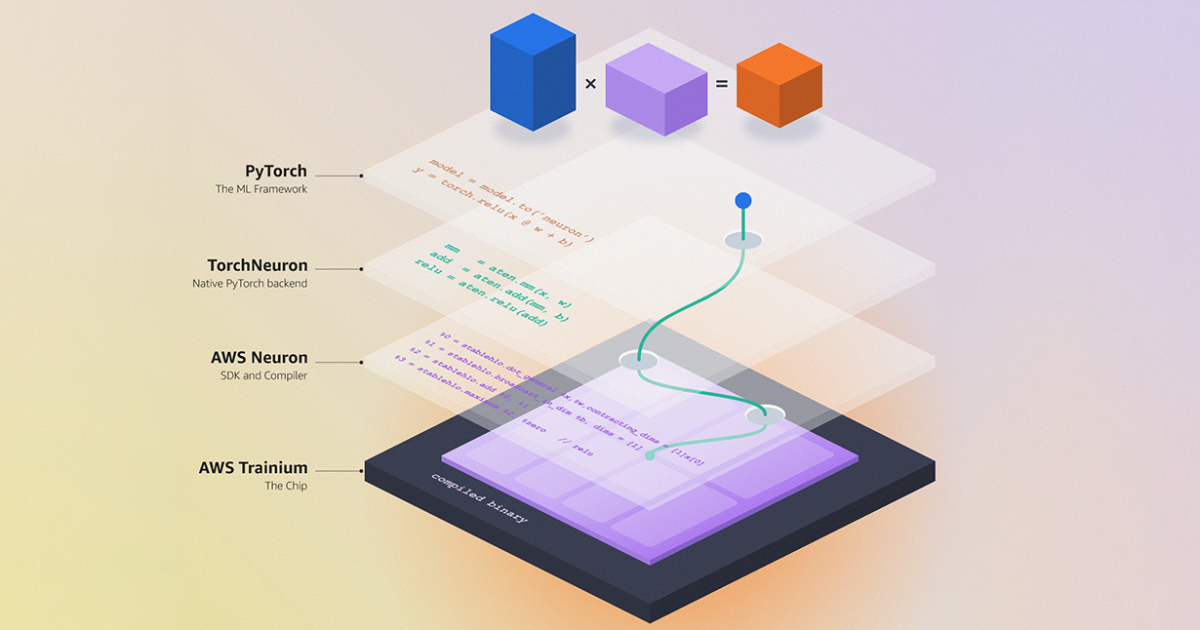
The science behind TorchNeuron, Amazon’s new PyTorch backend for AWS Trainium chips

Amazon 开源 TorchNeuron:PyTorch 代码近乎零改动即可运行于 Trainium

降低 PyTorch 训练负载迁移 Trainium 的门槛,Neuron SDK 提供周期级 profiler 与 NKI 近汇编级内核控制。
同一事件 · 另有 1 个来源报道▾
  • 博客TorchNeuron: running HF models on AWS Trainium is easier than everhuggingface.co
PyTorchTrainium开源amazon.science
博客AI 硬件内存、互联与网络5 天前
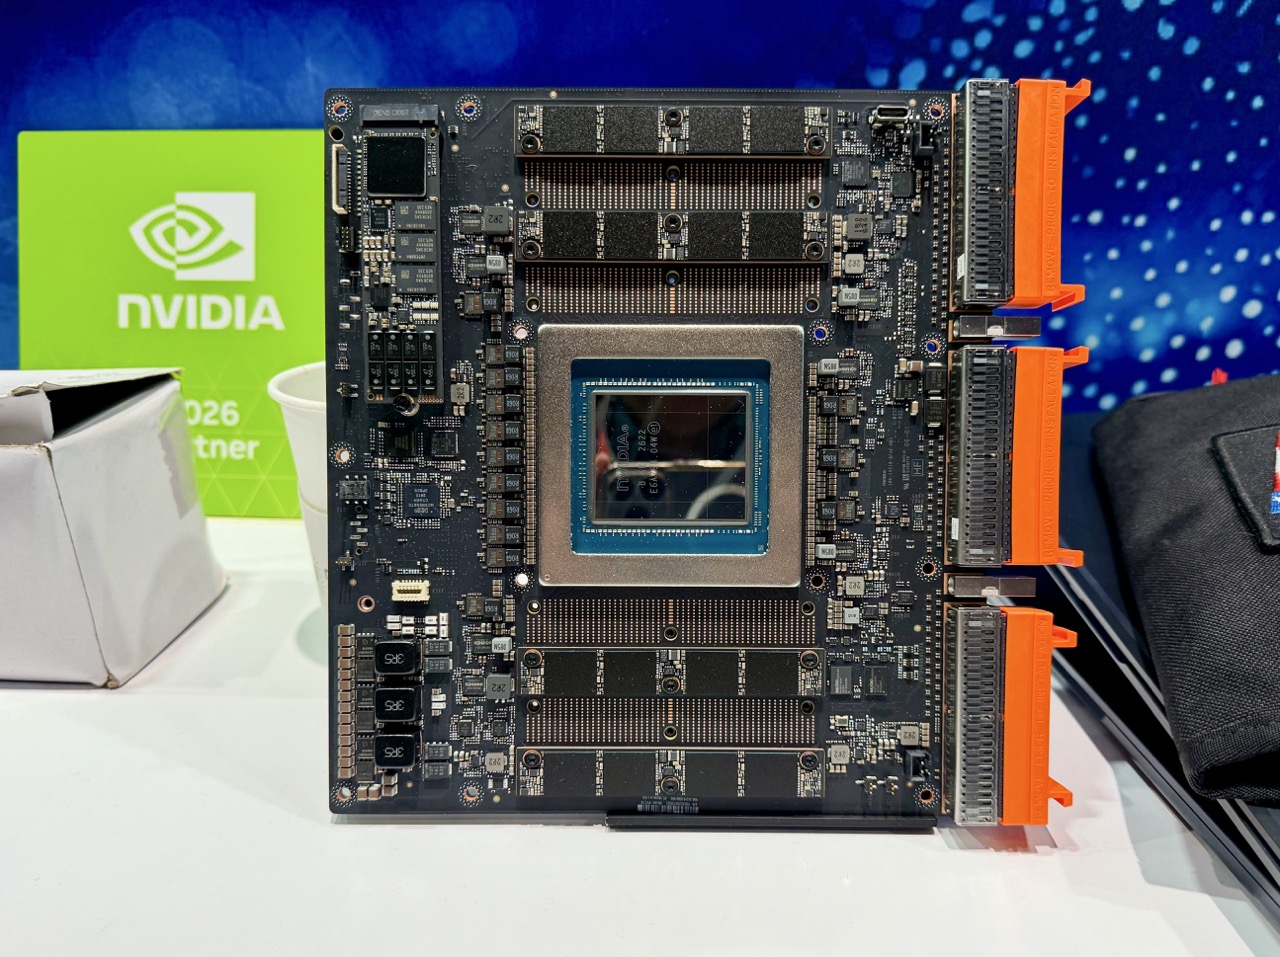
NVIDIA BlueField-4 STX Server for CMX at OCP 2026

NVIDIA OCP展示BlueField-4 CMX服务器

面向上下文内存的DPU/服务器方案,或影响长上下文推理基础设施。
AI硬件DPU长上下文servethehome.com
博客AI 硬件内存、互联与网络5 天前
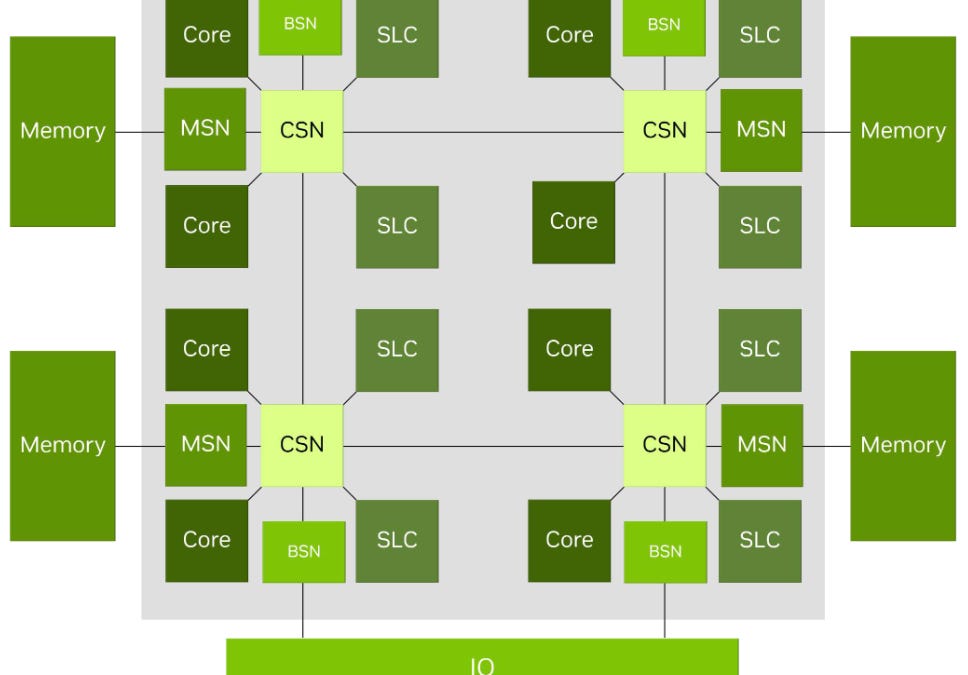
Nvidia Vera’s System Architecture: Pushing Bandwidth

Nvidia Vera用第二代SCF和LPDDR5X提升带宽

解释Vera核心、互连和内存路径,影响AI服务器推理与数据吞吐评估。
AI硬件互连内存带宽chipsandcheese.com
博客AI 硬件编译器与内核优化29 天前
A kernel-centric path to real-time video generation on Trainium

AWS Trainium 实时视频生成 kernel 方案

自回归 diffusion 动态形状与缓存优化可迁移,利好端侧/云端实时生成。
推理加速Trainium视频生成amazon.science
博客AI 硬件GPU 与加速器11 天前
Microsoft’s “Clea” Maia 300 Inference XPU Is A Bandwidth Beast

微软 Maia 300 推理 XPU 曝光,主打高带宽

若属实将影响云端推理算力成本与自研芯片竞争,需关注规格落地

AI芯片推理加速Microsoftnextplatform.com
博客AI 硬件端侧与边缘设备7 天前
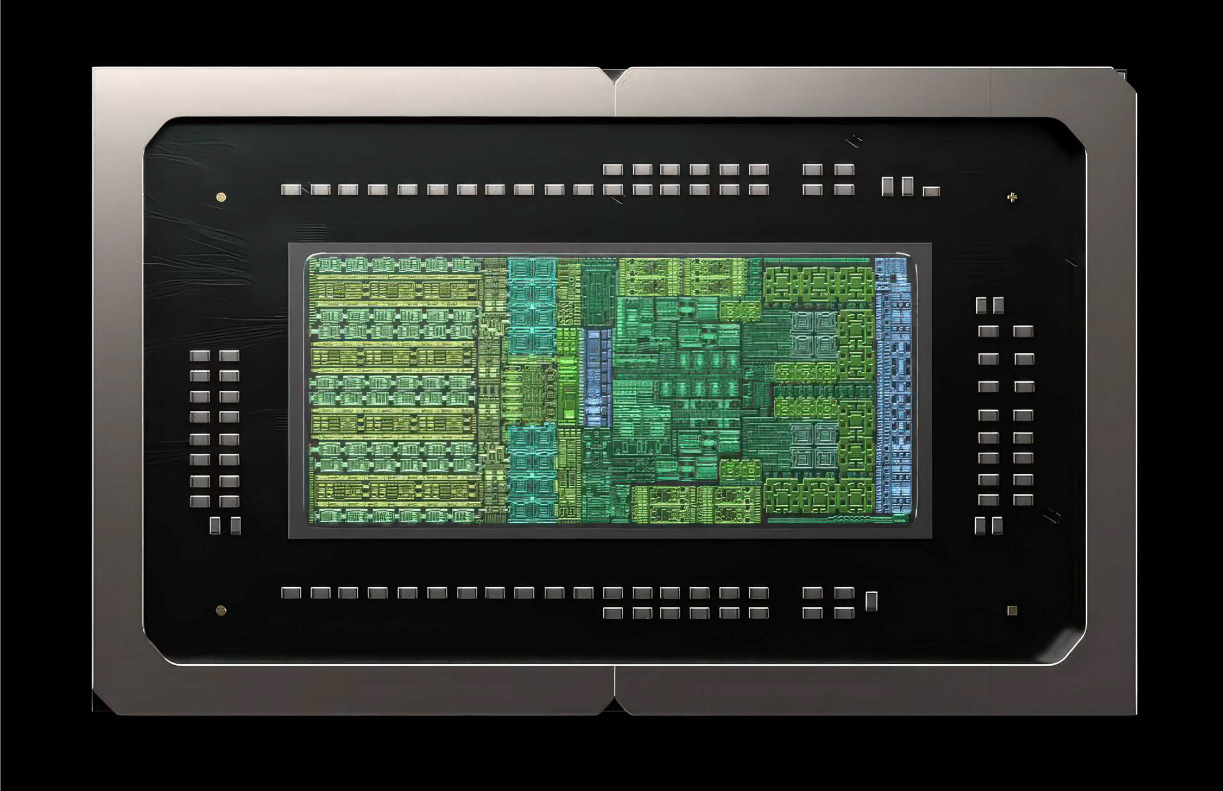
NVIDIA RTX Spark N1X Launch Overview: NVIDIA Arms Windows

NVIDIA 发布 RTX Spark N1X,将 GB10 SoC 引入 Windows

AI-focused SoC 进入 Windows 笔记本,推动本地推理与内容创作。
同一事件 · 另有 2 个来源报道▾
  • 博客Code, Test, and Deploy on One Machine with NVIDIA RTX Sparkdeveloper.nvidia.com
  • 博客Be There for the Beginning: Celebrate the Launch of NVIDIA RTX Sparkblogs.nvidia.com
AI硬件GB10Windowsservethehome.com
博客AI 硬件内存、互联与网络2026/08/30
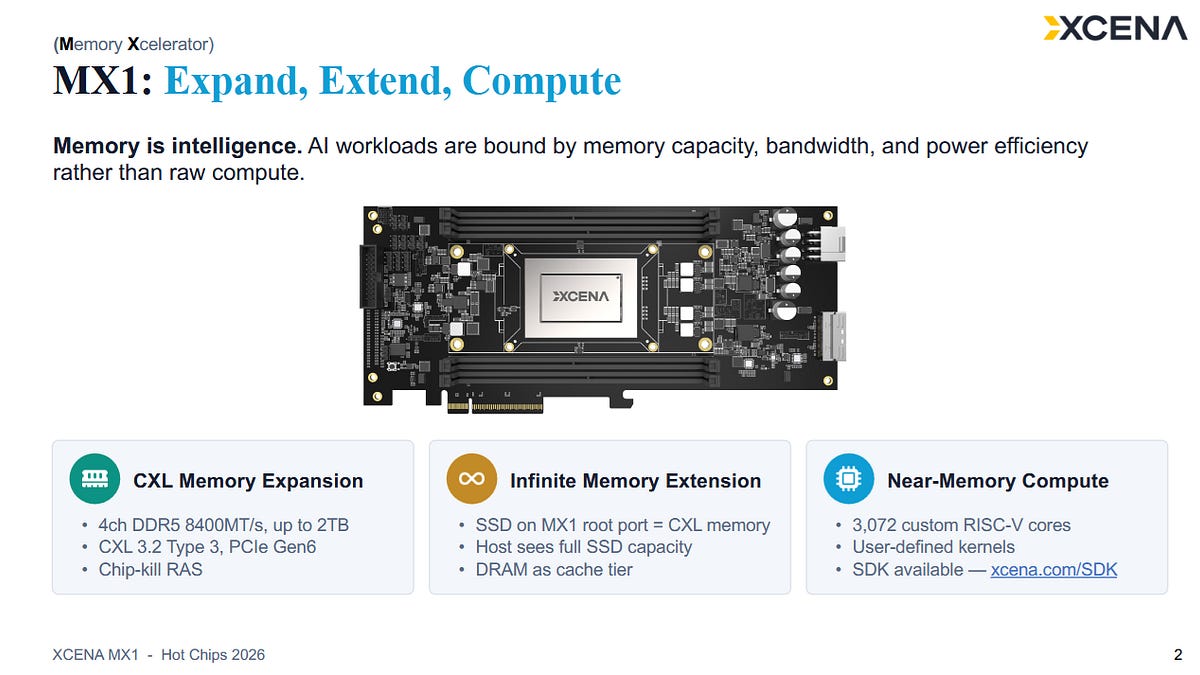
Hot Chips 2026: XCENA and Samsung’s Near-Memory Compute CXL Device

XCENA 与 Samsung 发布 MX1 CXL 近存计算设备

缓解大模型内存容量与带宽瓶颈,提供近存计算与缓存路径。
CXL近存计算RISC-Vchipsandcheese.com
博客AI 硬件编译器与内核优化5 天前
Accelerating Mamba-2 with High-Performance Forward Pass Kernels in NVIDIA CUDA Tile

NVIDIA 用 CUDA Tile Python DSL 编写 Mamba-2 前向高性能 kernel

展示用 Python 级 tile DSL 写 SSM kernel 的路径,对自研算子与 Mamba 推理优化有参考价值

CUDA TileMamba-2GPU kerneldeveloper.nvidia.com
博客AI 硬件编译器与内核优化2026/07/29
From CUDA to MLX: How K-Search Brings Decades of Kernel Expertise to Apple Silicon

K-Search 将数十年 CUDA 内核经验迁移到 MLX

面向 Apple Silicon 的 AI kernel 移植提供自动搜索与优化迁移思路,降低 CUDA 生态经验复用成本。

内核优化CUDAMLXbair.berkeley.edu
博客AI 硬件内存、互联与网络17 天前
Growing Pains: How Distributed AI Training Changes The Network Between Datacenters

文章讨论跨数据中心分布式AI训练网络新挑战。

提示大规模训练瓶颈从单数据中心互联扩展到长距离网络协调。

分布式训练AI基础设施网络nextplatform.com
博客AI 硬件产业与供应链2 天前
Three Physical Walls Are Hitting AI Datacenter Infrastructure at the Same Time - And the Compound Effects Are Worse

三堵物理墙同时冲击 AI 数据中心基础设施,复合效应更糟

信息不足,影响待观察

数据中心AI 基础设施算力nextplatform.com
博客AI 硬件端侧与边缘设备2026/08/12
NVIDIA JetPack 7.2.1 Adds Agentic Video Skills and T3000 Emulation

JetPack 7.2.1 新增 Agentic Video Skills

面向 Jetson 多摄像头视频与 AI 推理链路,为机器人视频处理提供智能体化能力,但具体细节有限。

NVIDIA JetsonJetPack视频处理developer.nvidia.com
第 1 / 2 页 · 共 13 条
1 / 2
12
← → 键翻页