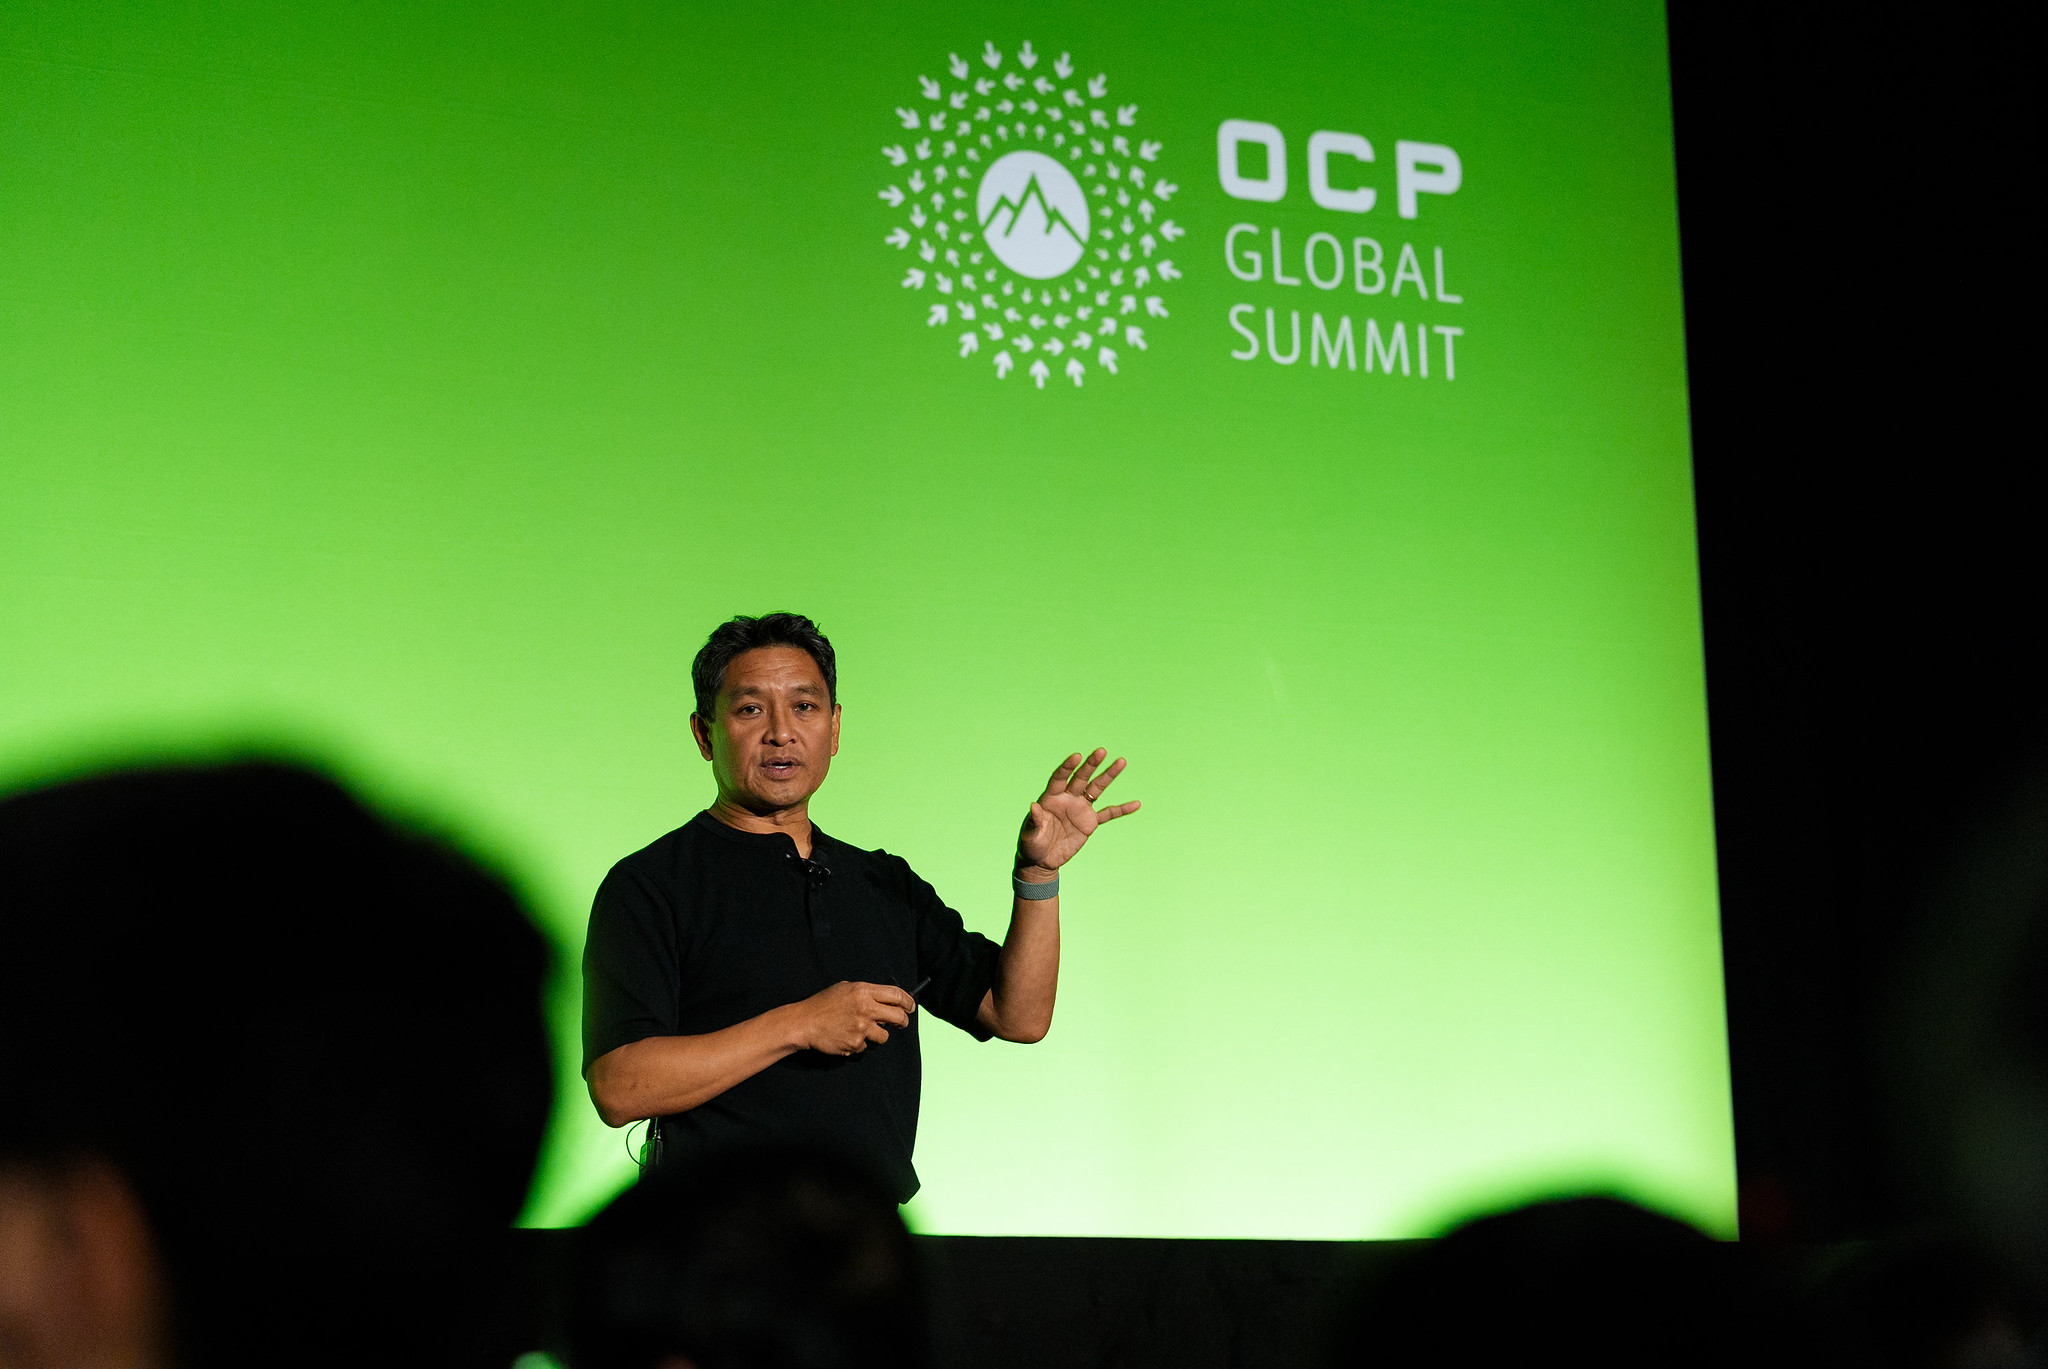
Inside Prometheus: Meta’s Journey to a Gigawatt-Scale SuperclusterMeta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
Meta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
展示万卡级训练集群在供电、散热与稳定性上的工程实践,对大规模 AI 训练基础设施设计有直接参考价值。

资料 47 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 20 分钟前
Meta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
展示万卡级训练集群在供电、散热与稳定性上的工程实践,对大规模 AI 训练基础设施设计有直接参考价值。
Meta 在 OCP 2026 发布 102.4T 交换平台与 FPF 网络
Meta 开放液冷机架、交换平台与 scale-out 网络,可供 AI 集群基础设施选型参考。
vLLM 双向 KV 传输:多轮 agent TTFT 最高提速 3.3 倍
针对多轮 agent 反复重算历史上下文的瓶颈,让 decode 节点回传 KV 供 prefill 复用,是 agent 服务降延迟的高价值工程方案。
NVIDIA Sentry 运行时监控 AI agent 安全
agent 可能绕过工具与凭证控制,运行时外置监控与强制执行为生产安全治理提供参考。

AWS Agent Registry实现运行时语义搜索发现MCP与A2A工具
解决工具目录扩大时硬编码接线瓶颈,减少token消耗并解耦团队发布
NVIDIA 将 Run:ai 平台全量开源,纳入 DSX AI Factory 体系
生产级 GPU 编排与负载调度开源,直接影响自建训练或推理集群的调度选型与厂商锁定评估
OpenAI 扩展 Habitat,ChatGPT 读取提速 12×
展示可靠多租户、全球缓存与 Azure Cosmos DB 的扩展方案,对大规模 ChatGPT 服务存储有参考价值。
vLLM push 式 KV 传输:TTFT 最高提升 3 倍,TPOT 提升 30%
把 KV 传输协调移出关键路径,是 P-D 分离推理在 RDMA 网络上的实用优化;做长 prompt 在线服务的团队可直接借鉴该 connector 设计。
ReplaySSM 重思混合模型状态存储,加速 SSM+Attention 解码
针对 Mamba-2/GDN/KDA 混合架构的固定状态复用问题给出解法,直接影响长上下文解码吞吐与显存占用,值得工程评估。
Olmo-core 3 发布全开源训练栈,支持 MoE 扩展至万亿参数
全开源的万亿参数级 MoE 训练栈可直接复用,显著降低大规模训练的工程门槛。
TensorRT 11.1 推出 Global Performance Tuner,自动精度感知的端到端调优
自动、精度感知的调优替代手工逐配置试错,降低 TensorRT 推理部署的优化成本。

torchtitan 在 trn2.48xlarge 上三种方式训练 Qwen3
展示 Trainium 原生 PyTorch 路径,便于迁移 Transformers 权重与 MoE 内核。