To Keep or Not to Keep: Learning KV Cache Retention in Disaggregated LLM Serving SystemsKVLearn 学习式 KV 缓存保留:分离式服务 TTFT 最高降 56%,传输量降 53%
KVLearn 学习式 KV 缓存保留:分离式服务 TTFT 最高降 56%,传输量降 53%
分离式推理中缓存决策需权衡重算与网络传输,该框架给出可落地的成本感知方案
资料 49 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 10 分钟前
KVLearn 学习式 KV 缓存保留:分离式服务 TTFT 最高降 56%,传输量降 53%
分离式推理中缓存决策需权衡重算与网络传输,该框架给出可落地的成本感知方案
LoRASpace:多 LoRA 动态推理快 6x 以上
训练无关地降低多 LoRA 组合推理成本,对 LoRA 池服务有工程参考价值。

编译 LLM 控制为并行推理,层次 RAG 控制延迟降 35–47%
为层次化 RAG 等结构化控制提供并行化路径,策略精确且延迟下降,对 LLM 推理加速有直接参考价值。

Ollama v0.40.8 上线 Flint,支持 262K 上下文
Apache 2.0 编码 MoE 模型接入 Ollama,长上下文与多轮工具调用面向代码智能体;当前支持 MacOS。
sglang v0.5.22 发布,DeepSeek-V4.1 H200 吞吐提升 2.3x
重要推理框架版本更新,带来多款新模型适配与 H200、B200、B300 等硬件性能优化,对后端部署有直接参考价值。
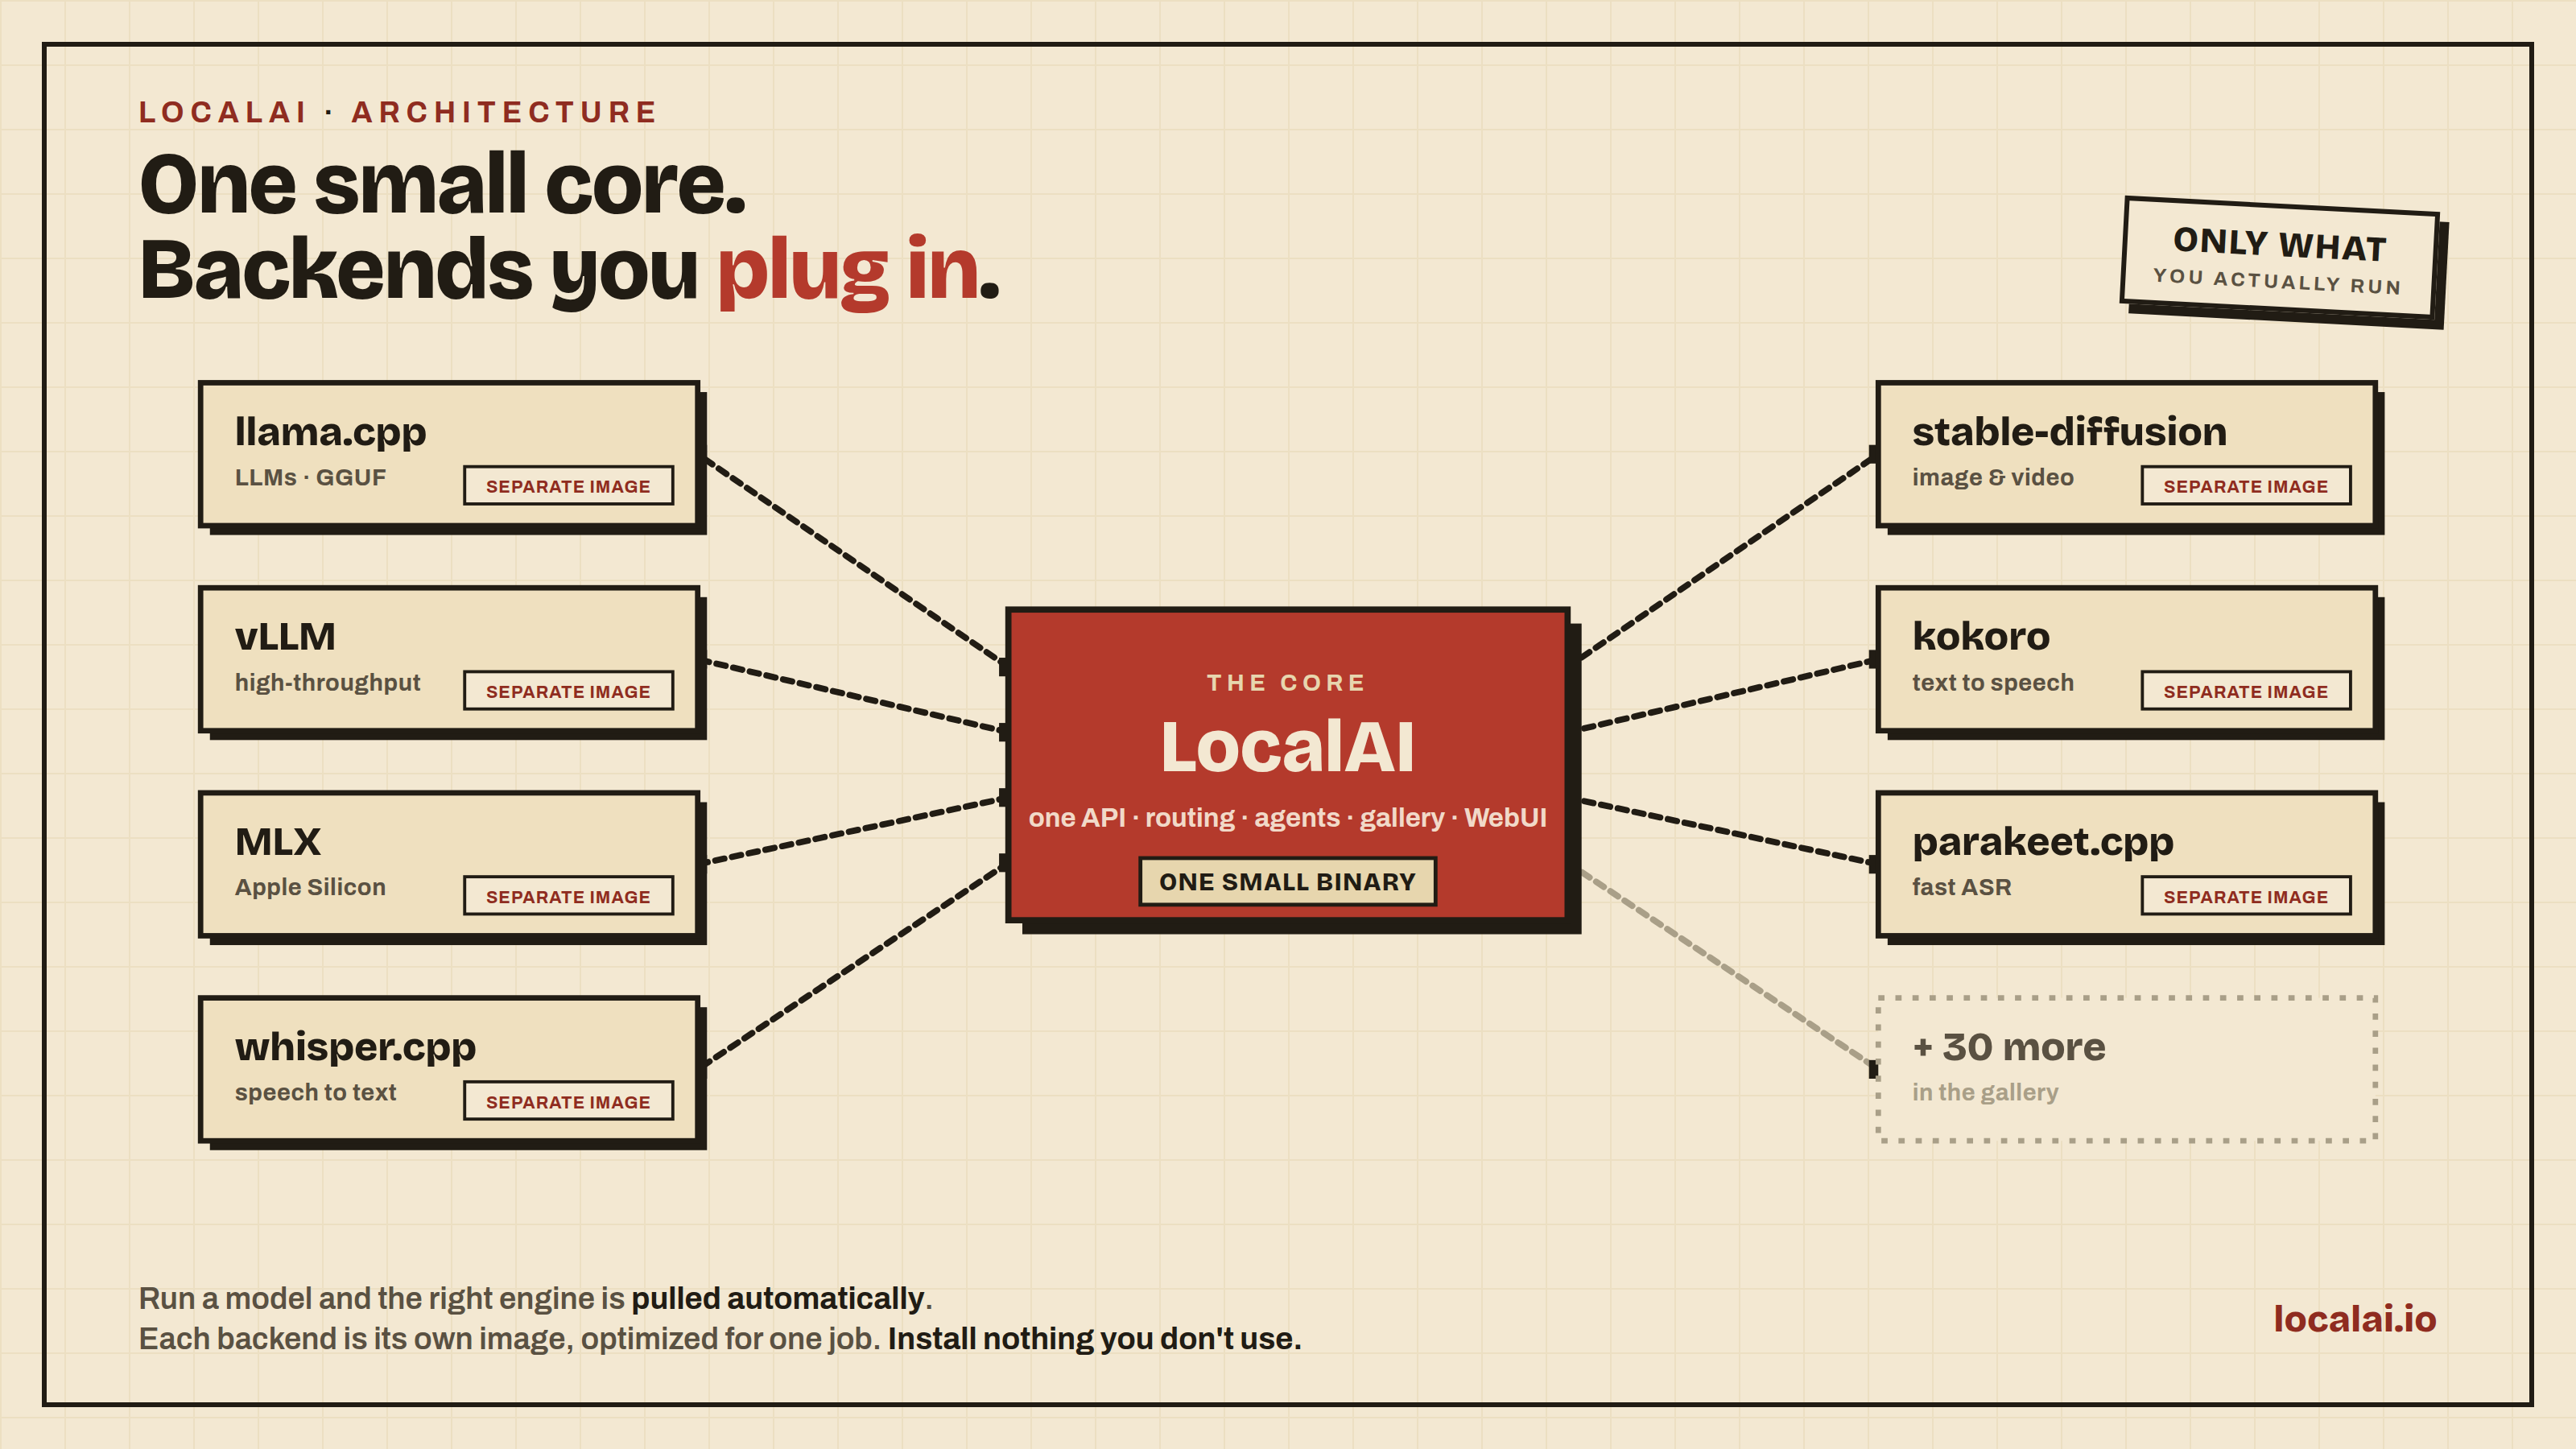
LocalAI 支持本地运行 LLM/视觉/语音等多模态模型,无需 GPU
为本地/离线/边缘部署多模态模型提供统一开源引擎,显著降低硬件门槛与集成成本
vLLM 双向 KV 传输:多轮 agent TTFT 最高提速 3.3 倍
针对多轮 agent 反复重算历史上下文的瓶颈,让 decode 节点回传 KV 供 prefill 复用,是 agent 服务降延迟的高价值工程方案。
MPQ 改进 PTQ:覆盖 2-bit 至 4-bit 量化
将 PTQ 建模为码本后验推断并保留软后验信息,可改善 Llama、Qwen、Mistral 的量化质量,值得评估。
Ollama v0.40.9 新增 Phonon 语音与 d3 决策模型
Ollama 增加语音输出端点与决策模型,便于应用集成语音和分类/评分能力。
HAWK 实现 GPU-NPU 分离式推理的 KV cache 跨设备直传,成本效率达 1.72×
prefill/decode 分置 GPU/NPU 可显著提升能效与成本效率,为异构推理集群设计提供可参考的工程方案。

UlaCache 统一逻辑地址管理稀疏 KV cache,B300 TP 峰值吞吐 2.51×
为长上下文稀疏注意力的 KV 管理给出系统级方案,逻辑地址抽象与 PB-LRU 可直接借鉴到 serving 工程
vLLM 提供高吞吐、内存高效的 LLM 推理服务
LLM 服务化的主流开源推理引擎,适合评估吞吐、显存与部署成本。