AI 硬件 / 项目
VecSzn/PolyStrata
语言占比
- C++ 61.8%
- Python 21.8%
- Cuda 13.1%
- Metal 1.3%
- CMake 0.8%
- 引擎
- 2 个(Strata + PolyStrata)
- 平台
- Windows / Linux;Mac 仅 Qwen3.8
- 显卡
- NVIDIA RTX 20-50 / AMD RX 6000-9000
- 磁盘
- 11-114 GB 按模型
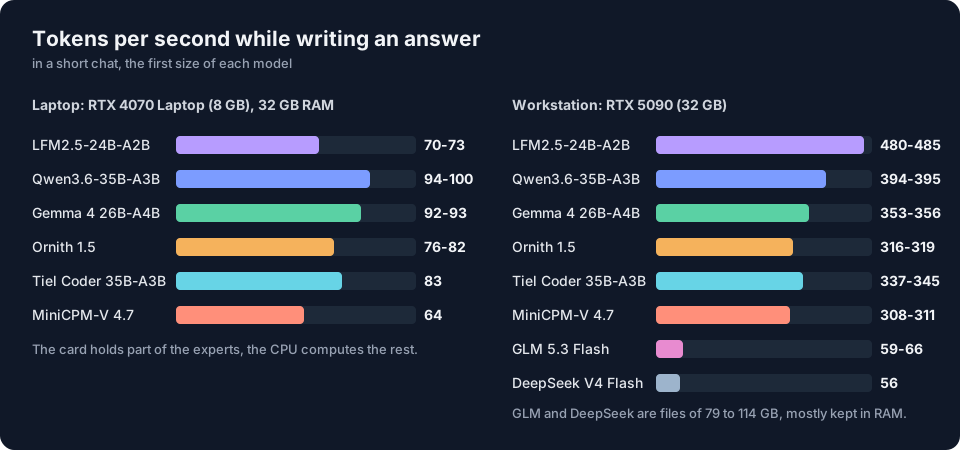
480-485
LFM2.5写
RTX 5090
23,390-23,460
LFM2.5读
RTX 5090
94-100
Qwen3.6写
8GB 笔记本
59-66
GLM写
RTX 5090
1,040
DeepSeek读
RTX 5090
注释 · 读取指吞入长文档、代码或聊天历史的速度;60 t/s 输出已快于人阅读。出自 README·How fast is it
- serve/95 个文件
本地 HTTP 服务与 Web 应用
- core/
核心推理逻辑
- kernels/
CPU/GPU 计算内核
- README.md
项目介绍、模型清单、速度与安装说明
- setup.py
一键安装与启动进程编排
代码分布(各目录文件数)
- bench/2281 个
- src/298 个
- sycl/239 个
- tools/203 个
- docs/157 个
- include/150 个
- serve/95 个
- metal/89 个
- tests/57 个
- (根目录文件)30 个
- 1Windows 启动$ START-HERE.bat
- 2Linux / macOS 启动$ ./setup.sh
- 3跑速度基准$ python polystrata.py benchmark --model <name> --prompt-tokens 24000
- 4Anthropic API 接入$ ANTHROPIC_BASE_URL=http://127.0.0.1:8080
中文(AI 翻译)
原文
方法、结果与局限
1 / 8
判断
混合计算架构
24,576 个专家写一个词只需 10 个,GPU 缓存热专家、RAM 全量、SSD 存 n-gram 表。
判断
原文称:GPU 持 attention、DeltaNet、routers、shared experts、输出头、MTP 草稿层与自适应 术语解释GPU 显存里缓存近期最高频专家,随对话自适应;RAM pinned 全部专家,CPU 用 AVX-512/AVX2 内核就地计算未命中项;SSD 放 28.8GB n-gram 表,每 token 只读几行。每多 1GB VRAM 约多放 700 个专家,所以显存容量比 GPU 速度更重要。
注释 · 核心是让 CPU 与 GPU 并行计算冷热专家,而不是把 79-114GB 模型硬塞进显存。出自 docs/HOW_IT_WORKS.md