Training the Whole Agent, Not Just the ModelHarnessAdapt-RL同步训练策略与harness,SWE-bench Verified pass@1提升9.8个百分点
HarnessAdapt-RL同步训练策略与harness,SWE-bench Verified pass@1提升9.8个百分点
联合优化策略与执行框架可显著提升编码智能体在SWE-bench任务解决率,对RL训练范式有直接工程启示。
资料 75 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 54 分钟前
HarnessAdapt-RL同步训练策略与harness,SWE-bench Verified pass@1提升9.8个百分点
联合优化策略与执行框架可显著提升编码智能体在SWE-bench任务解决率,对RL训练范式有直接工程启示。
开源 30B 端侧智能体模型 Muse Glimmer:4-bit 量化单卡可跑
30B 级开源模型把多步规划、工具调用与失败恢复塞进消费级硬件,端侧 Agent 部署与隐私敏感场景多了一个可评估选项

adk-python 发布 v2.12.0,长会话首模型请求时间降低 40%
长会话性能提升明显,并新增工具输出过滤、人工确认与专用服务账号部署,值得 agent 工程评估。
ClawMMU 为 LLM 智能体长期记忆加来源标签,阻止隐藏指令提权
为有状态智能体的记忆来源与权限治理提供可落地防护思路,帮助缓解提示注入和工具结果投毒。
COMPASS 路由:DeepSWE 准确率 78.1%
无需训练路由权重即可依据性能与成本证据选模型,对多模型编排和成本控制有直接参考价值。
微软开源 Agent Lightning v1.0:3500 行实现 Agent RL 训练闭环
让部署用的 agent harness 直接参与 RL,免去重写 agent;6k 样本把 SWE-bench Verified 提升 14.6 个点,工程可复用性强。
adk-python v2.13.0:12 项特性转稳定,新增 TypeSafe 分类与实时语音
Google 官方 Agent 框架重要更新:Jev 单次前向输出校准概率、快于 LLM,实时语音支持 barge-in,值得评估。
Sage-A1.5 35B MoE 智能体模型发布,关注长程任务与科学探索
展示长程智能体在编排、验证和科学发现上的能力组合方法,对复杂 Agent 系统设计有直接参考价值。

DynaWeave 动态场景训练智能体,CostBench 完成率升 67.34 个百分点
直击静态训练环境与真实动态环境脱节的痛点,为智能体 SFT 提供可验证的数据合成管线,且代码开源。

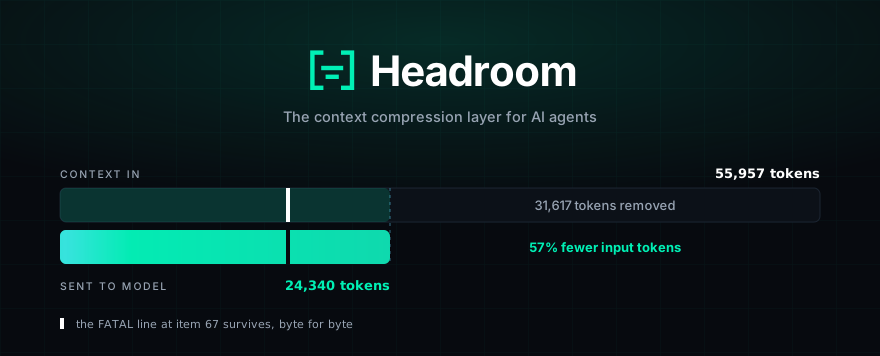
Headroom 压缩工具输出与 RAG 内容以降低 LLM token
可压缩工具输出、日志和 RAG 片段,直接降低 agent 上下文成本。
Databricks 在 Agent Bricks 推出 Agent Memory
主流数据平台增加原生 agent memory,可能简化生产智能体状态与记忆管理,需评估与现有数据栈集成。

OpenGCUA 发布首个全栈开源通用电脑使用智能体
对标闭源 CUA,把视觉+程序化接口的统一决策与代码执行开源,可用于自建桌面 Agent
