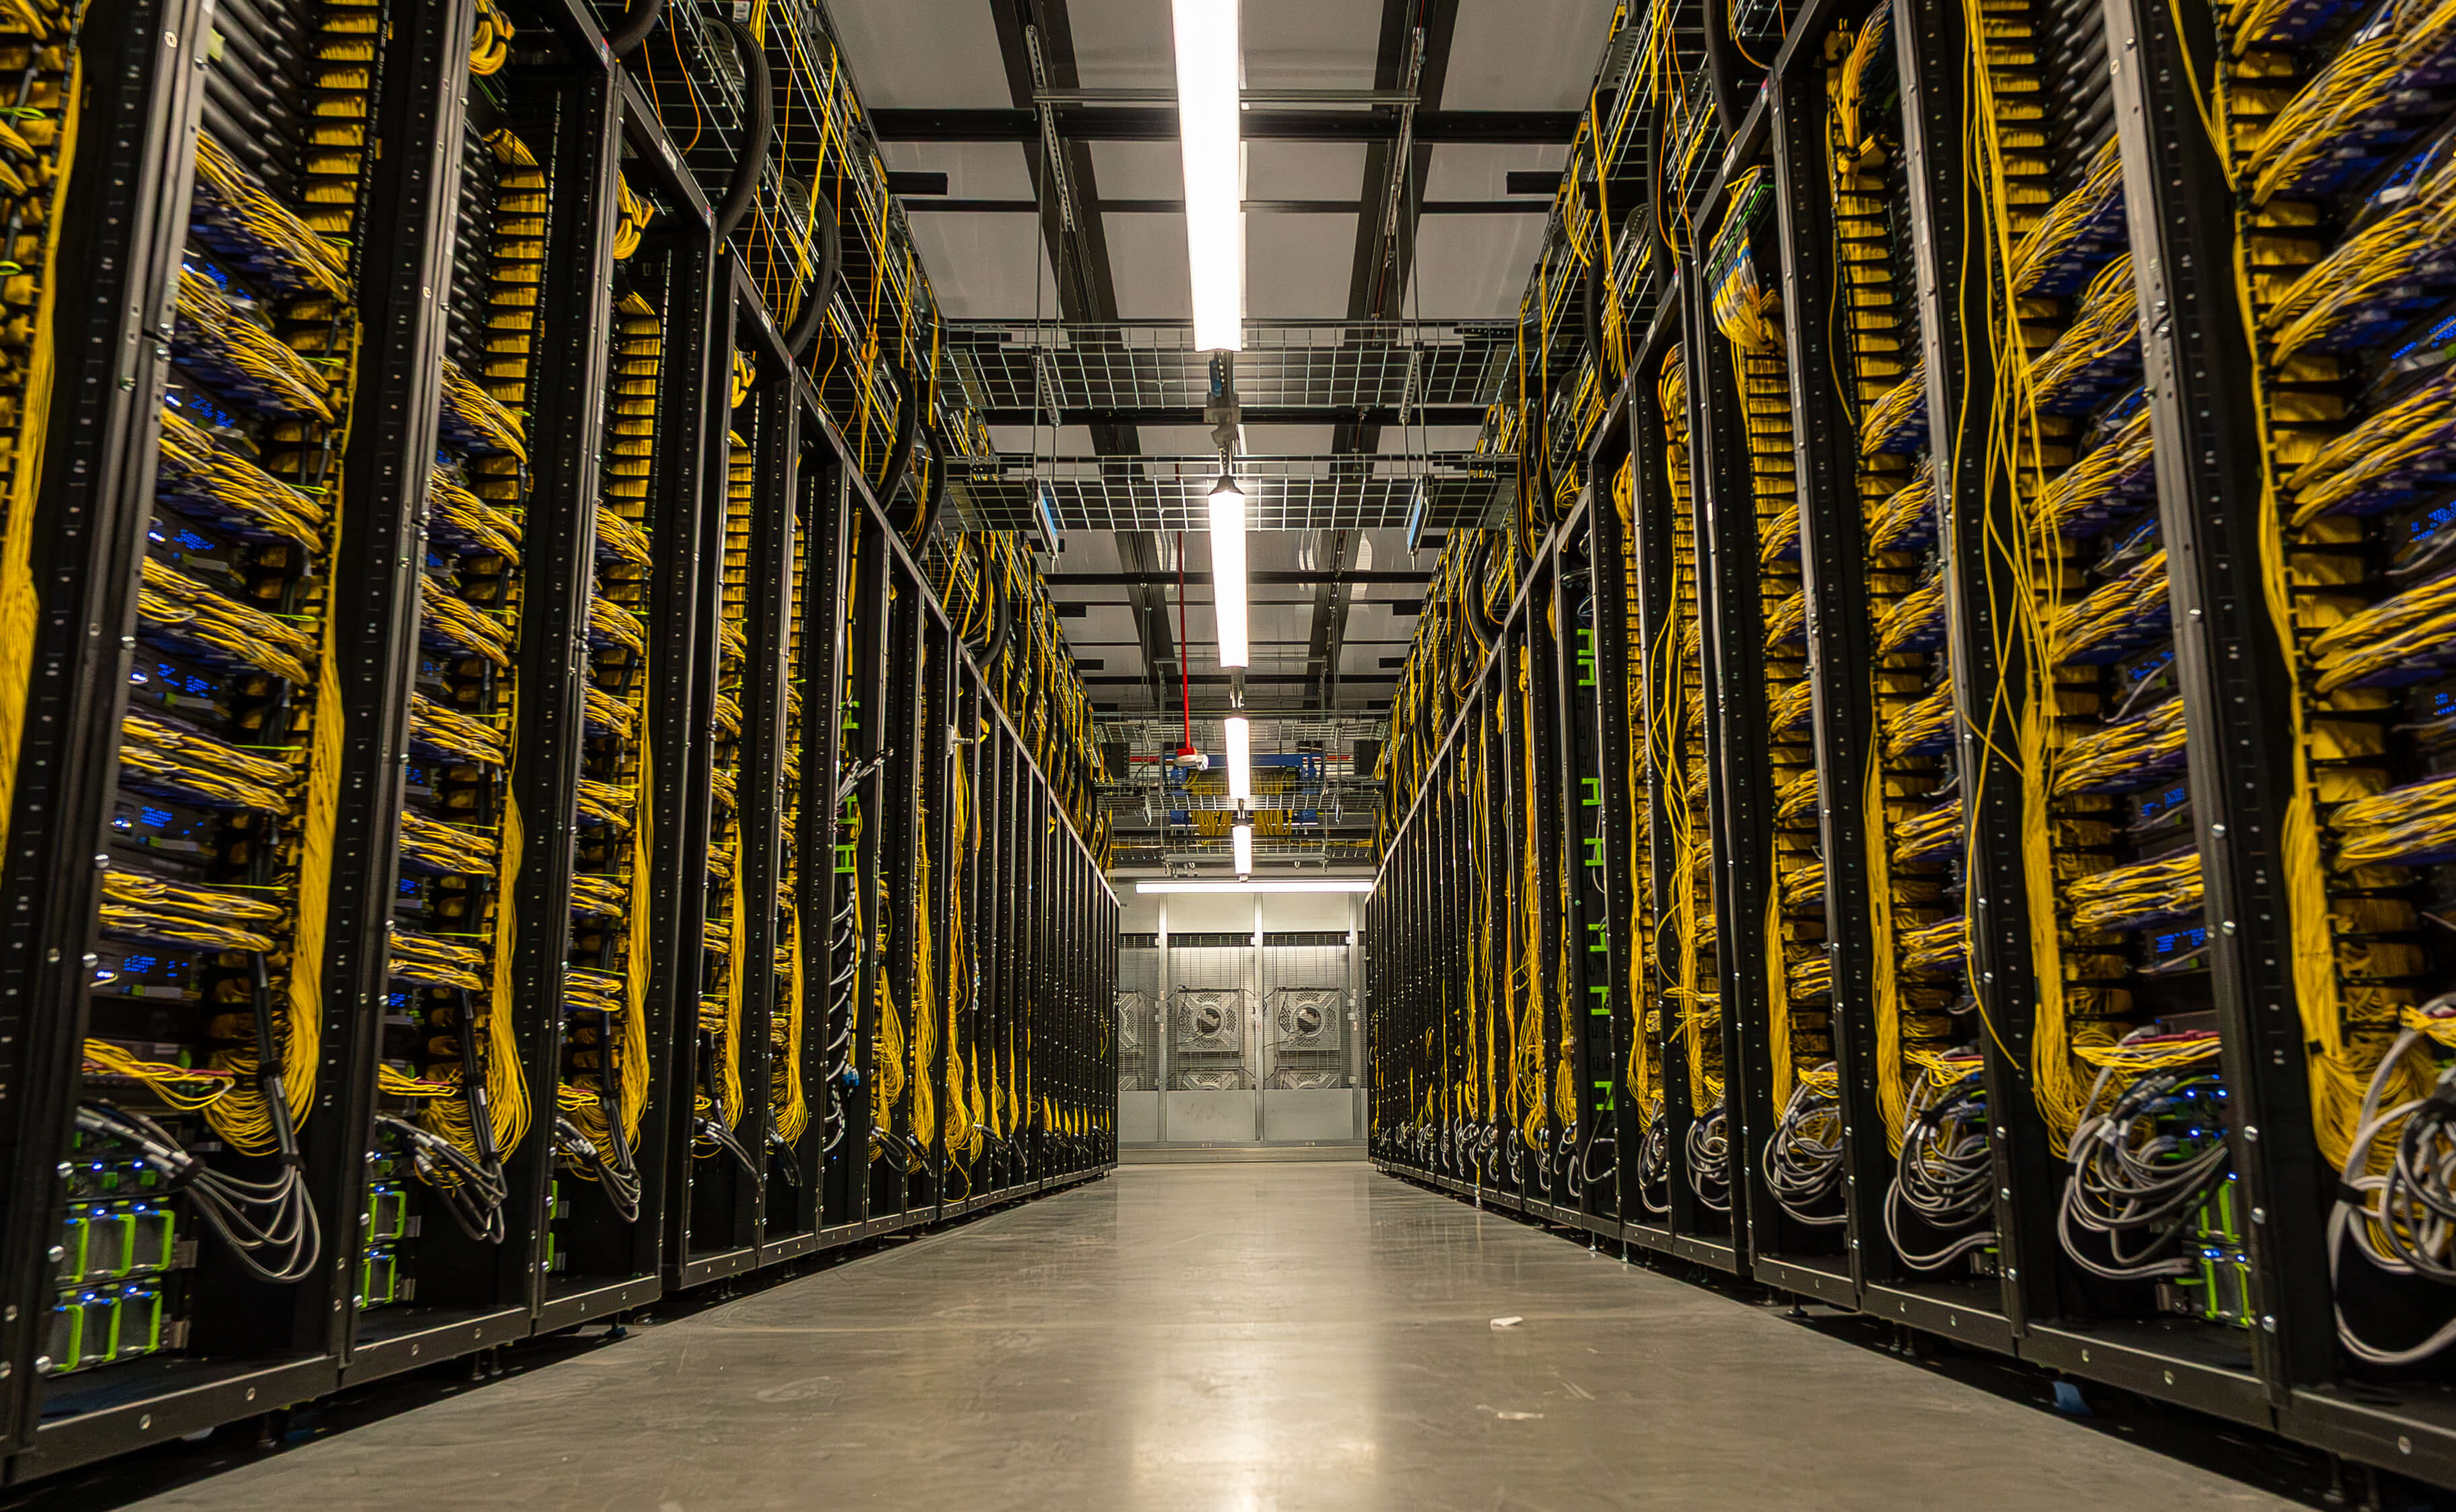
Inside Prometheus: Meta’s Journey to a Gigawatt-Scale SuperclusterMeta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
Meta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
展示万卡级训练集群在供电、散热与稳定性上的工程实践,对大规模 AI 训练基础设施设计有直接参考价值。
资料 49 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 10 分钟前
Meta 公布 Prometheus 超算一期完成,目标扩展至 ~1 million GPUs,已训练 Muse 模型
展示万卡级训练集群在供电、散热与稳定性上的工程实践,对大规模 AI 训练基础设施设计有直接参考价值。
Meta 在 OCP 2026 发布 102.4T 交换平台与 FPF 网络
Meta 开放液冷机架、交换平台与 scale-out 网络,可供 AI 集群基础设施选型参考。
NVIDIA 将 Run:ai 平台全量开源,纳入 DSX AI Factory 体系
生产级 GPU 编排与负载调度开源,直接影响自建训练或推理集群的调度选型与厂商锁定评估
8 个 DGX Spark 节点运行前沿 AI 模型,需 数百 GB 内存
展示桌面级 Spark 节点扩展运行大内存模型的路径,对本地多模型编排与硬件选型有参考。