OpenAttention: One Percent Is Enough with Tail ProxiesOpenAttention:1% 读取保留 99% 精度
OpenAttention:1% 读取保留 99% 精度
对长上下文推理有直接加速意义,1% 读取下 decode attention 快 10×,可评估用于稀疏注意力内核。

资料 53 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 4 分钟前
OpenAttention:1% 读取保留 99% 精度
对长上下文推理有直接加速意义,1% 读取下 decode attention 快 10×,可评估用于稀疏注意力内核。
1.78M 轮测试:投机接受率不随位置衰减
纠正长 CoT 投机解码随位置衰减的误解,提示工程应关注反思触发 token 的熵而非位置。
DStill 将一步草稿接受长度提升 28%,最高提速 6.45×
将多步扩散草稿蒸馏为一步,提升推测解码接受长度与推理速度,可用于低延迟 LLM 服务。
SQuAT 将格 VQ-QAT 扩展到 10B token、训练加速 12.8 倍
为低比特 LLM 量化训练提供 shape-gain 分离 STE 新方法,训练 12.8 倍加速,对量化部署与分布式训练有参考价值。
BeNice 实现循环模型 KV 共享,缓存命中率最高提升 31.4%,TTFT p90 下降 83.6%
为循环架构长上下文推理提供新优化路径,可与 multi-latent attention、fp8/nvfp4 量化等组合,降低内存并提升吞吐。

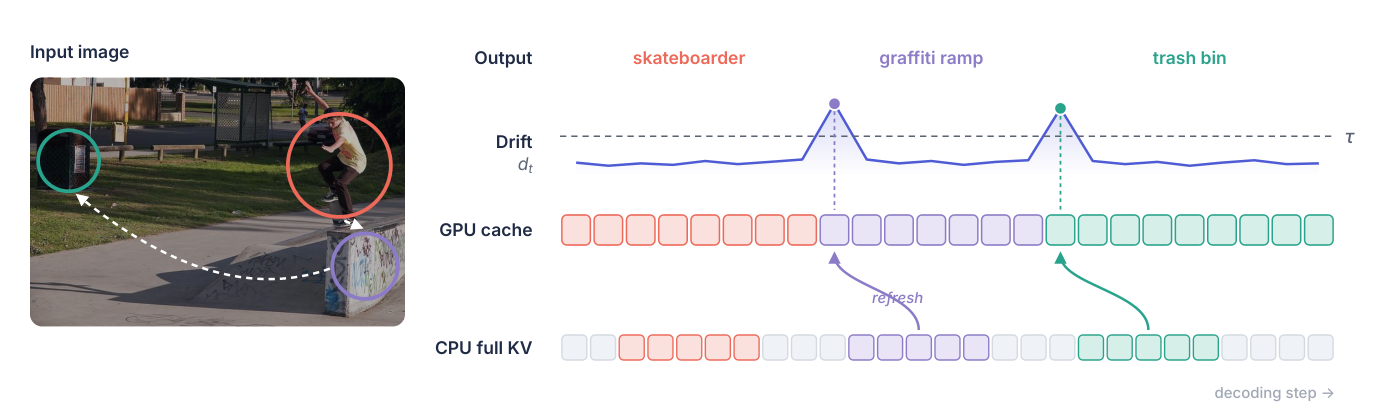
RCR 重选 KV,超 InfiniGen 1.6-3.8 ROUGE-L
一次性视觉 token 选择限制长文本生成;按注意力漂移与预算刷新,可改善多模态 KV 压缩。
OPTIC 压缩 Gemma 4 E4B PLE 100×,保留 97.8%
针对嵌入参数占比高的趋势,显著降低推理 GPU 内存,且速度损失极小。
