Rewriting Scaling Laws for Synthetic Data with Compute and Data Constraints合成重写 scaling law:最优重写比例可达 32%
合成重写 scaling law:最优重写比例可达 32%
把合成重写纳入 scaling law,可预测最优重写比例与计算预算,并显示重写训练可超过 rewriter,指导预训练数据工程。

资料 53 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 11 分钟前
合成重写 scaling law:最优重写比例可达 32%
把合成重写纳入 scaling law,可预测最优重写比例与计算预算,并显示重写训练可超过 rewriter,指导预训练数据工程。
开源320B总参数(15B激活)MoE模型 IQuest-Q1,面向 Agentic CLI
开源大规模MoE基础模型及三阶段训练细节,为智能体编码任务提供可复用模型与训练策略。

OpenAttention:1% 读取保留 99% 精度
对长上下文推理有直接加速意义,1% 读取下 decode attention 快 10×,可评估用于稀疏注意力内核。

1.78M 轮测试:投机接受率不随位置衰减
纠正长 CoT 投机解码随位置衰减的误解,提示工程应关注反思触发 token 的熵而非位置。
发布 PLE 基准:85 个长程物理工程任务,最强配置仅 50.6%
首次用可签字、可计费的物理工程设计交付物评测智能体,暴露出最强配置也仅有 50.6% 且成本极高,可作为工程选型与评测参考。

LARE 五基准平均提升 +7.84 pp,GSM8K +17.06 pp、MATH +9.00 pp
不增加数据暴露,仅调整领域损失权重即可同时提升知识、数学与代码能力并减少遗忘,对预训练数据混合有直接工程价值。
短格式不便宜:规格比代码短 25–48%,但未更快更可靠
对 LLM 应用设计有直接启示:推理模型只缩短输出 token 不能降低延迟/提升可靠性,需评估格式的上下文学习成本。

SANE 验证测试族达 JRH 的 3.7 倍
LLM judge 广泛用于评测与训练,该方法自动生成分数器测试,提升可靠性验证。
DStill 将一步草稿接受长度提升 28%,最高提速 6.45×
将多步扩散草稿蒸馏为一步,提升推测解码接受长度与推理速度,可用于低延迟 LLM 服务。
SQuAT 将格 VQ-QAT 扩展到 10B token、训练加速 12.8 倍
为低比特 LLM 量化训练提供 shape-gain 分离 STE 新方法,训练 12.8 倍加速,对量化部署与分布式训练有参考价值。
开源英德 MoE Kolibri:78.1B 总参、3.46B 激活
开放权重并披露数据、训练与后训练全流程,对多语言主权模型和 MoE 服务成本评估有参考价值。
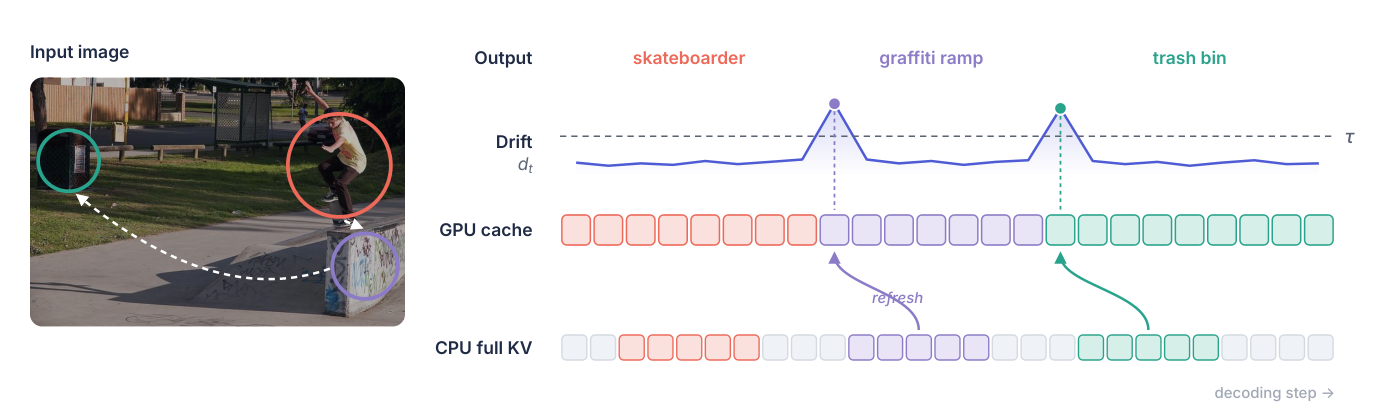
RCR 重选 KV,超 InfiniGen 1.6-3.8 ROUGE-L
一次性视觉 token 选择限制长文本生成;按注意力漂移与预算刷新,可改善多模态 KV 压缩。