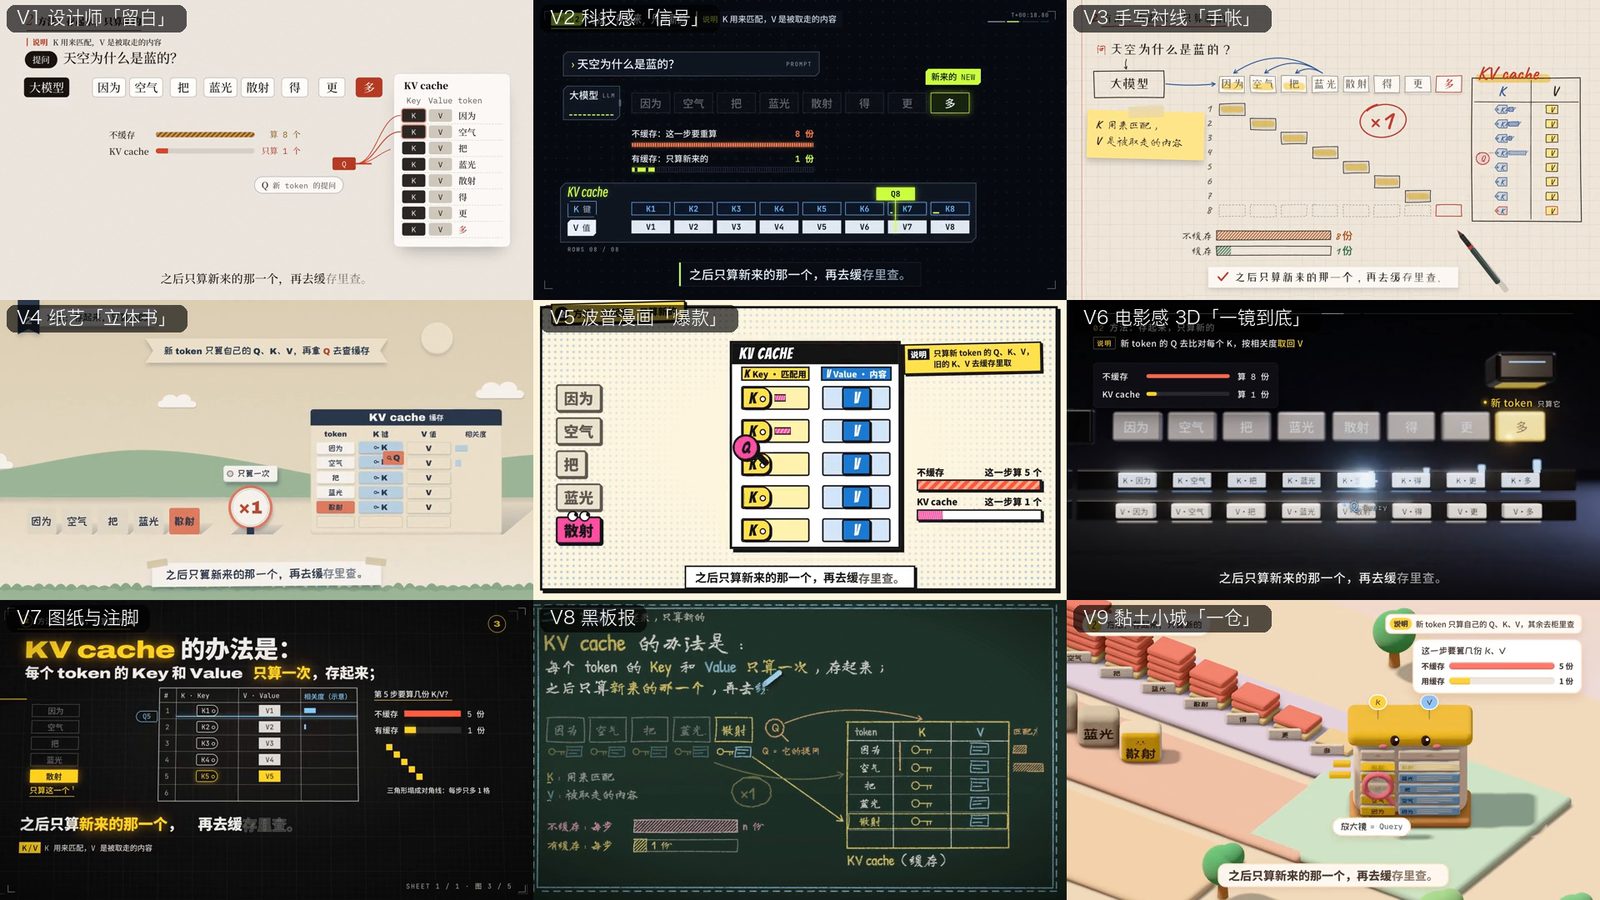
FlashML-org/FreeVideoFreeVideo 可在 8GB VRAM、16GB RAM 上运行 MiniMax H3 生成视频
FreeVideo 可在 8GB VRAM、16GB RAM 上运行 MiniMax H3 生成视频
大幅降低视频生成本地推理的硬件门槛,使消费级设备即可运行 MiniMax H3,便于快速实验与部署。
资料 50 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 1 分钟前
FreeVideo 可在 8GB VRAM、16GB RAM 上运行 MiniMax H3 生成视频
大幅降低视频生成本地推理的硬件门槛,使消费级设备即可运行 MiniMax H3,便于快速实验与部署。
DeepSeek 视觉工具箱支持图片问答、OCR与UI还原
为纯文本模型补齐视觉输入,适合 agent 截图/OCR/前端还原工作流。
VoiceStudio:本地开源语音克隆,支持 646 种语言
本地开源语音克隆与转录方案,可作为 ElevenLabs 替代评估起点。
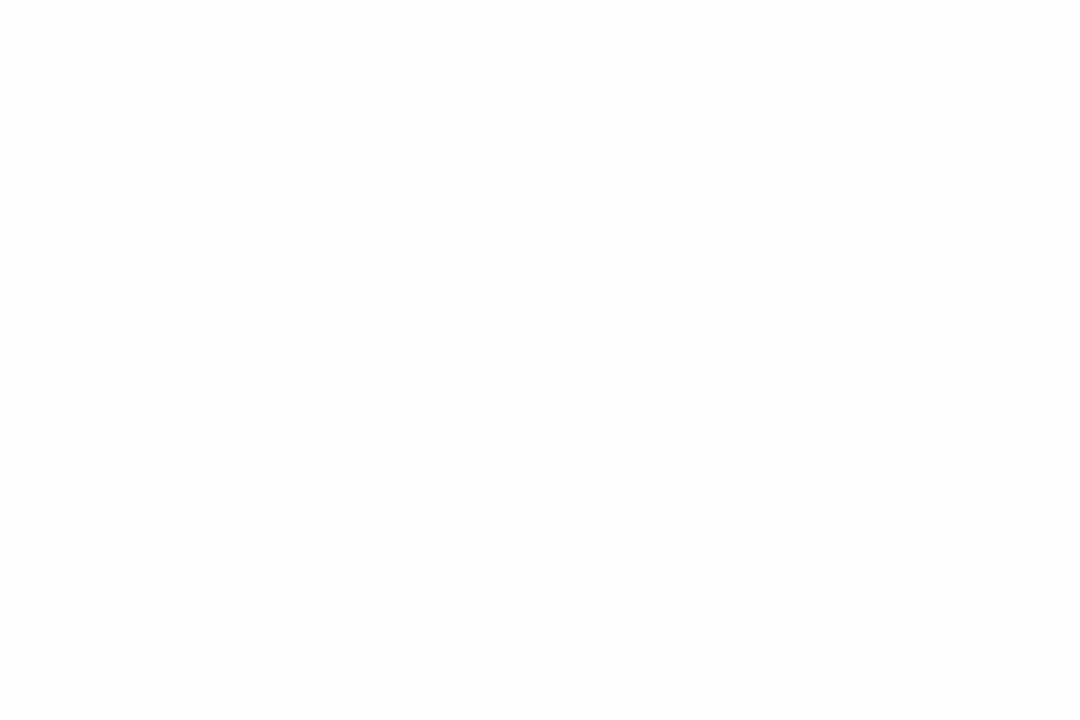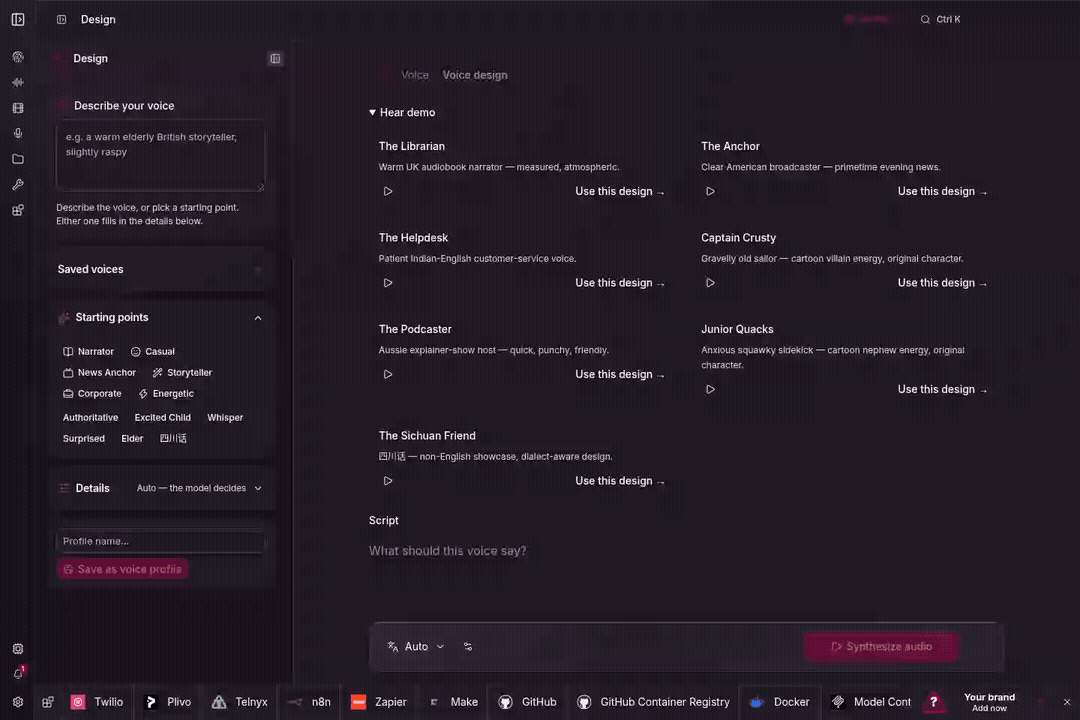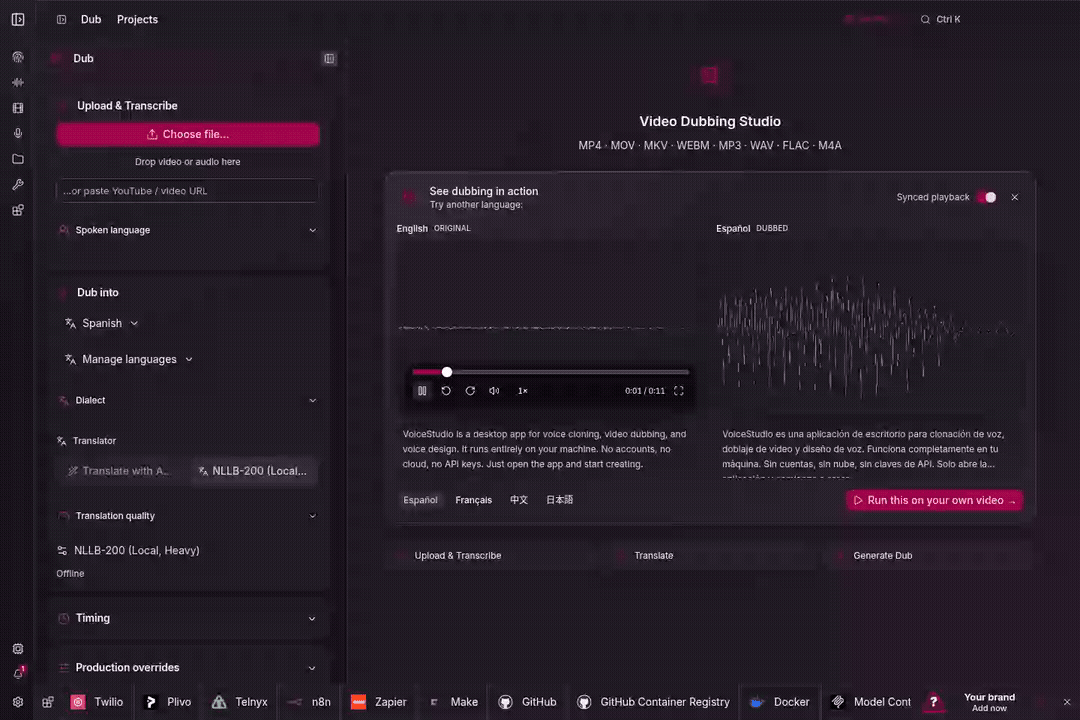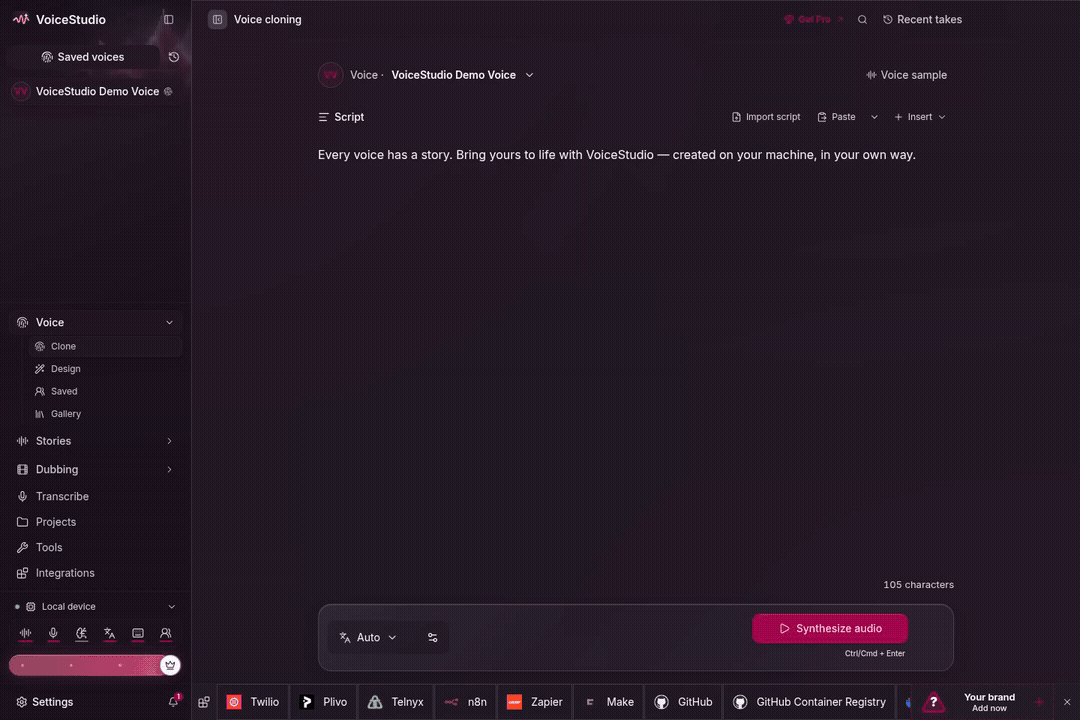
本地文件多模态搜索工具DigUp基于EmbeddingGemma 2
提供跨平台端侧检索实践,可评估用于数据闭环与知识管理。
agent-vision-toolkit 为纯文本模型补齐看图与 GUI 自动化
可让 Codex/Claude Code 等 Agent 低成本获得多图理解、长截图 OCR 与 GUI 操作能力
Open-Generative-AI 自托管 600+ 图像视频模型
自托管聚合多模型,便于本地 AIGC 评估;无内容过滤有合规风险。

Provider-neutral Codex Skill 从脚本和授权图像生成 AI presenter 视频
将脚本与授权形象生成数字人视频的能力封装为可复用技能,可低成本集成到内容生成流程中。