发布大模型效率与长上下文7 天前
vllm v0.32.0
vLLM v0.32.0:NVFP4/FP8 KV cache 全面落地,814 次提交
低精度 KV cache 与 Elastic EP、GPU n-gram 投机解码直接影响显存占用与吞吐,值得尽快评估升级
共 50 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 25 分钟前
已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。
vLLM v0.32.0:NVFP4/FP8 KV cache 全面落地,814 次提交
低精度 KV cache 与 Elastic EP、GPU n-gram 投机解码直接影响显存占用与吞吐,值得尽快评估升级
Anthropic 开放 MHS 研究预览,硬件集成降至小时/分钟
提供 agent 操作实验与制造设备的共享规范,降低硬件集成成本,利于自动化实验与具身工作流。
SQuAT 将格 VQ-QAT 扩展到 10B token、训练加速 12.8 倍
为低比特 LLM 量化训练提供 shape-gain 分离 STE 新方法,训练 12.8 倍加速,对量化部署与分布式训练有参考价值。
投影蒸馏最小编辑失败尝试,8 of 9 对比领先 GRPO/OPD
针对困难问题上 on-policy 学习无信号的问题,提出近 on-policy 蒸馏方法并有理论保证,可改善后训练能力保留与专业化权衡。
Gemini 2.5 访问仅限活跃用户,新项目用 3.5 Flash-Lite 或 3.8 Flash
影响现有使用 Gemini 2.5 的项目,新项目需迁移到 3.5 Flash-Lite 或 3.8 Flash,避免 API 访问中断。
Anthropic 推出 EFS,联合超 100 家客户强化企业安全
为企业级 Claude 部署提供客户云数据驻留、零数据保留和误用检测方案。

BeNice 实现循环模型 KV 共享,缓存命中率最高提升 31.4%,TTFT p90 下降 83.6%
为循环架构长上下文推理提供新优化路径,可与 multi-latent attention、fp8/nvfp4 量化等组合,降低内存并提升吞吐。

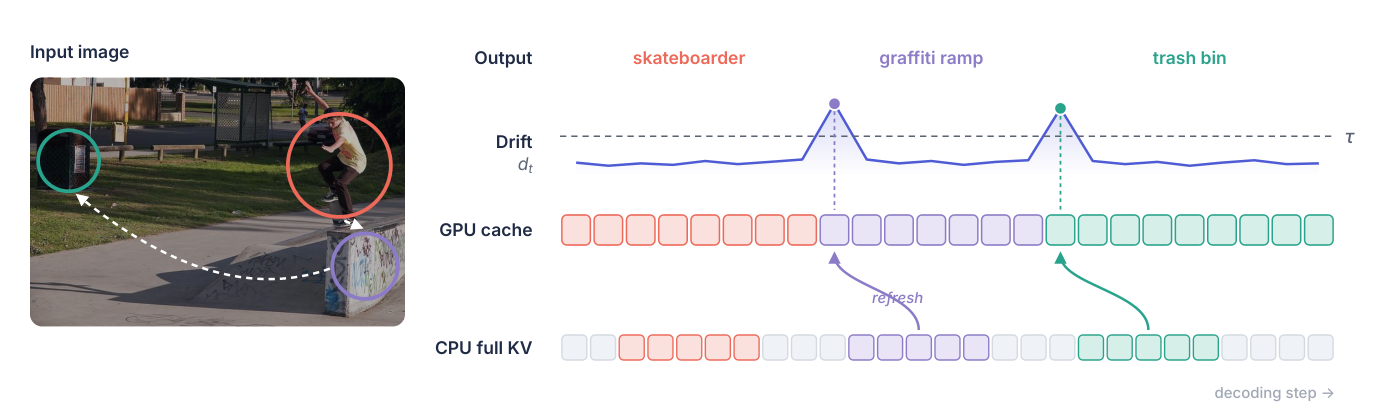
RCR 重选 KV,超 InfiniGen 1.6-3.8 ROUGE-L
一次性视觉 token 选择限制长文本生成;按注意力漂移与预算刷新,可改善多模态 KV 压缩。
OPTIC 压缩 Gemma 4 E4B PLE 100×,保留 97.8%
针对嵌入参数占比高的趋势,显著降低推理 GPU 内存,且速度损失极小。

Claude 形式化验证 123 个开源库,发现数百个逃过数万亿次测试的 bug
LLM 将 fuzz 测试转化为数学规约并批量生成证明,让形式化验证有望在普通开源项目中规模化落地
Dreaming Learning 高温采样正则化缓解模型崩溃,124M GPT-2 有效
为模型在合成数据上的训练提供直接正则化,有助于数据闭环中抑制多样性损失和性能退化。

跨语言 LLM 流程可复用性获验证:Gemini 3.5 Flash 提取准确率 95.2-97.6%
为多语言金融 NLP 部署提供依据:英文流程可条件复用,但仍需按语言和领域验证;推理努力的迁移效果因领域而异。
