AI 研究助理

基于站内最新资料,回答 AI 前沿问题

回答带出处引用,支持多轮追问

快速响应
AI 前沿跟踪
今日首页重点内容GitHub 趋势榜
领域
学术研究
大模型
具身智能
AI 基础设施
智能体 · Skill · MCP
机器人
多模态
自动驾驶
数据 / MLOps
AI 硬件
安全对齐
综述与报告

多模态

共 50 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 56 分钟前

已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。

全部 50发布 0论文 20模型 5项目 8工具 0数据集 0报告 0博客 17综述 0
细分方向全部视觉语言理解 17图像生成与编辑 7视频生成 7语音与音频 43D 与空间智能 1全模态与统一模型 2文档与 OCR 0
项目多模态图像生成与编辑3 天前
Anil-matcha/Open-Generative-AI

Open-Generative-AI 自托管 600+ 图像视频模型

自托管聚合多模型,便于本地 AIGC 评估;无内容过滤有合规风险。

开源AIGC视频生成本周 +842github.com
博客多模态3 天前
NVIDIA Confidential Computing Expands, Enabling Frontier Model Builders to Securely Scale Across Global Infrastructure

NVIDIA 机密计算新增 Confidential Bare Metal

面向前沿模型构建者新增裸金属机密计算选项,提供传输保护、平台完整性度量与硬件级访问控制。

Confidential Computing裸金属AI 安全blogs.nvidia.com
博客多模态视觉语言理解9 天前
NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning

NVIDIA 开源 Nemotron 3.5 Super VL:120B MoE 多模态智能体模型

开放可定制的 MoE 多模态模型,面向长流程企业智能体,值得评估部署成本

多模态MoE开源模型developer.nvidia.com
博客多模态语音与音频2026/08/18
Sharing a new way to work with Stable Audio

Stable Audio 3.0 新增 DAW 插件与网页高级生成体验,可迭代编辑与混音

将音频生成直接嵌入 DAW 工作流并支持网页端迭代编辑、混音,便于音频工程师在现有环境中使用生成模型。

音频生成DAW多模态stability.ai
项目多模态视频生成13 天前
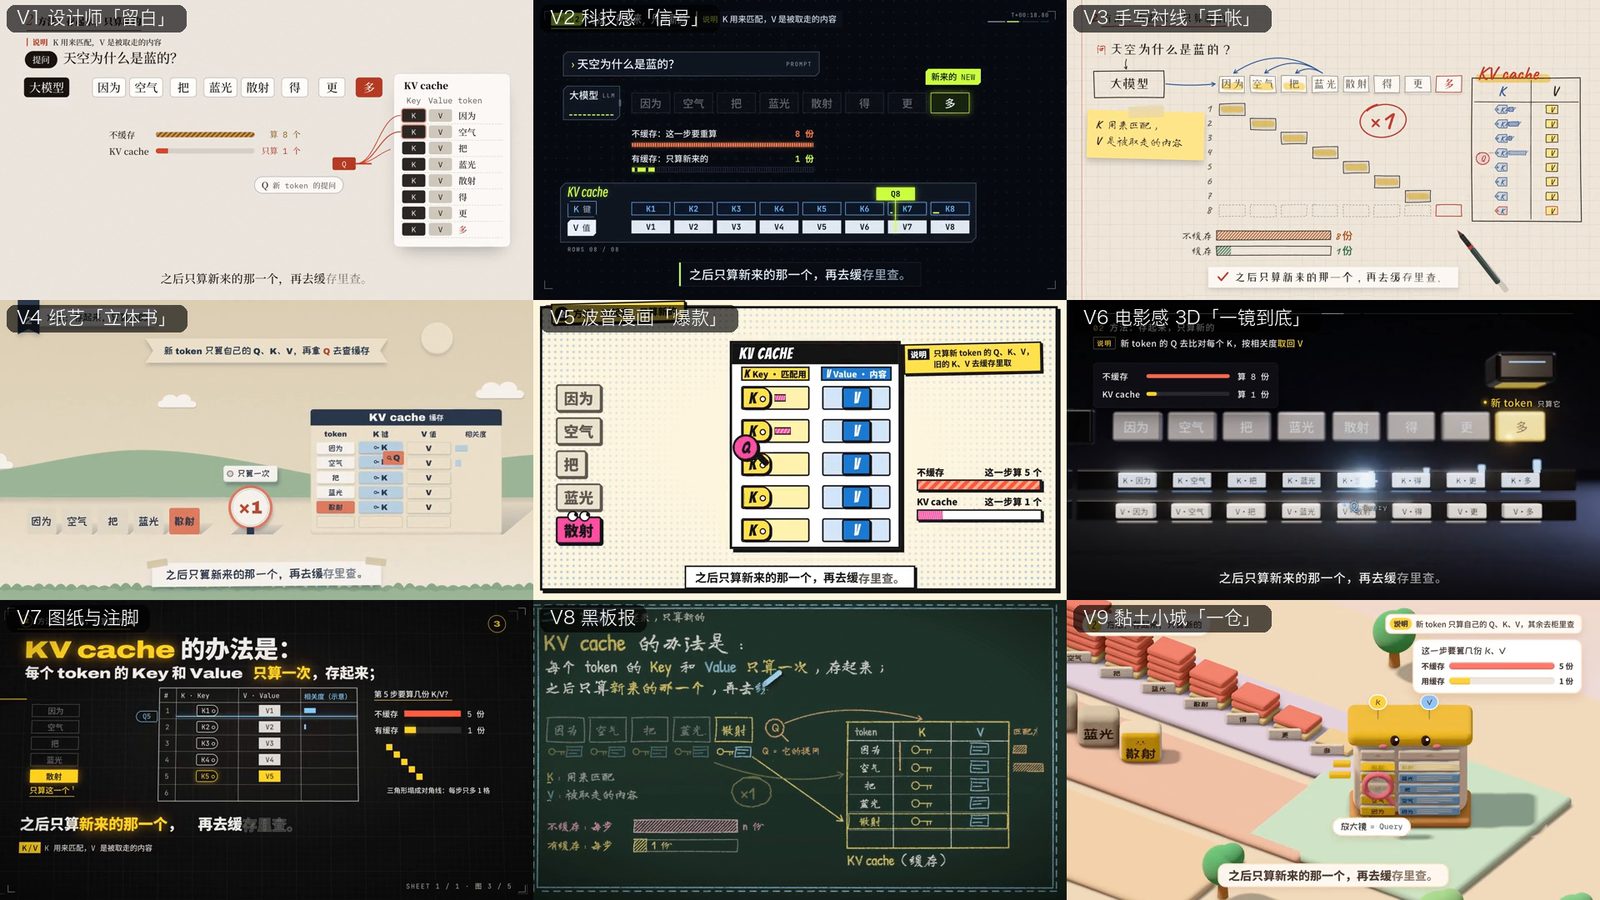
cclank/lanshu-create-ai-presenter-video

Provider-neutral Codex Skill 从脚本和授权图像生成 AI presenter 视频

将脚本与授权形象生成数字人视频的能力封装为可复用技能,可低成本集成到内容生成流程中。
Codex Skill多模态AI 视频2.8kgithub.com
博客多模态3 天前
Leading European Financial Services Organizations Embrace Open Models to Build Proprietary Intelligence

Revolut 部署 PRAGMA,服务 80 million 客户

展示金融交易规模下开放基础模型与自有算力落地,对数据闭环与生产扩展有参考。

开放模型金融AI基础模型blogs.nvidia.com
项目多模态视觉语言理解3 天前
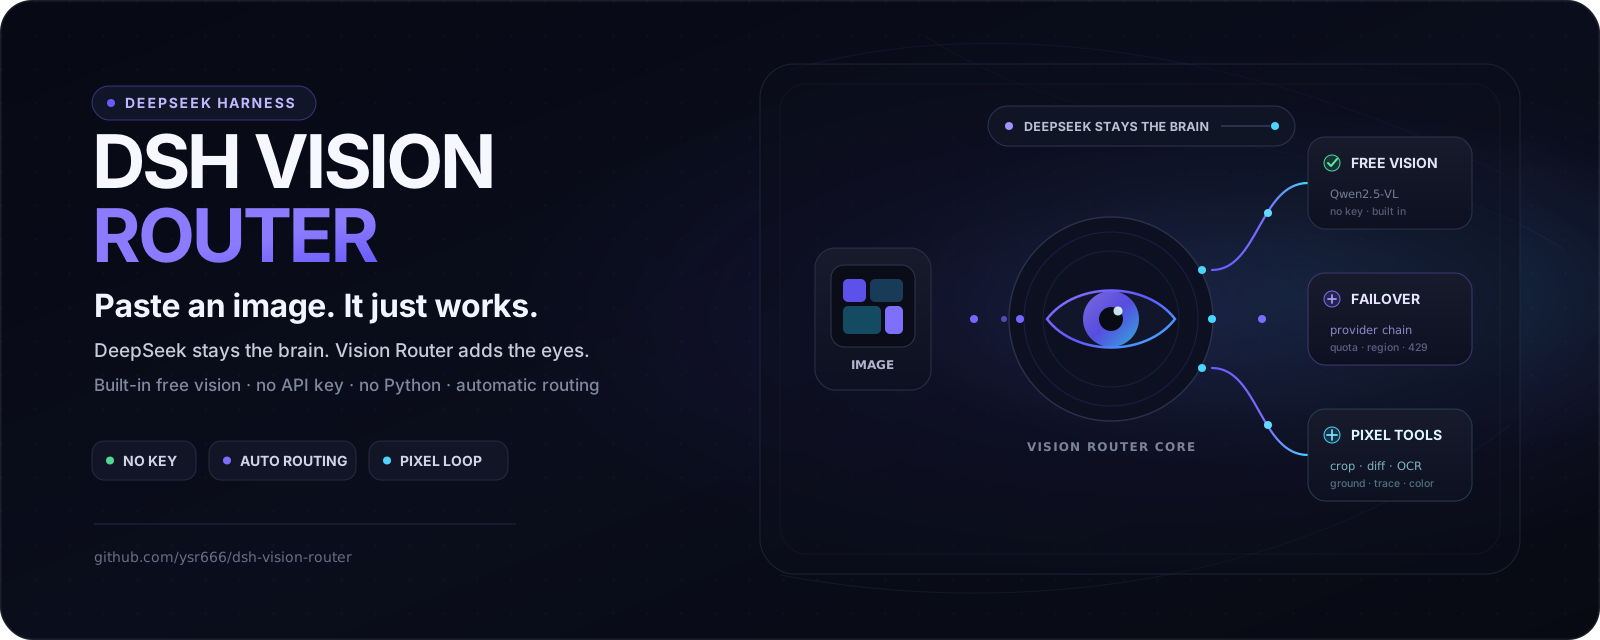
ysr666/dsh-vision-router

dsh-vision-router 给 DeepSeek 加视觉

为纯文本 agent 免 key 接入 OCR、grounding 等像素级视觉工具,降低多模态集成成本。
多模态DeepSeektool calling1.2kgithub.com
模型多模态视觉语言理解★ 重点来源2 天前
tencent/WeVisOne-VL-4B

tencent/WeVisOne-VL-4B:image-text-to-text,apache-2.0,transformers

信息不足,影响待观察

视觉语言模型image-text-to-textapache-2.0huggingface.co
模型多模态视觉语言理解★ 重点来源12 天前
nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16

NVIDIA 发布 Nemotron-3.5-Super-VL-120B-A12B(BF16)image-text-to-text 模型

信息不足,影响待观察

Nemotron多模态模型发布huggingface.co
模型多模态全模态与统一模型★ 重点来源2026/09/16
inclusionAI/Realtime-Venus

inclusionAI 开源 Realtime-Venus,any-to-any 模型,License apache-2.0

信息不足,影响待观察

any-to-any多模态开源模型huggingface.co
论文多模态4 天前
LightCRS: Lightweight Multi-Domain Conversational Recommendation System

LightCRS 将多域推荐 HR@1 提升 35.4%

5.3M 参数共享模块与离线表示把延迟降 266 倍,对多域多模态推荐工程有参考价值。

多模态推荐VLM低延迟arxiv.org
论文多模态图像生成与编辑6 天前
MOSS-Image Technical Report

MOSS-Image 开源 5B DiT,强化长文本渲染与版式控制

开放权重模型补上密集文字与复杂排版短板,并配长文本评测基准,可直接评估替换闭源方案

文生图开源模型DiTarxiv.org
第 3 / 5 页 · 共 50 条
3 / 5
12345
← → 键翻页