论文多模态图像生成与编辑NeurIPS 20263 天前
Velocity Ambiguity Profiles: Time-Resolved Bayes-Risk Diagnostics for Flow Matching
提出 VAP:CIFAR-100 速度损失降 6.78%、FD 降 23.6%
提供可定位模糊受限/数据受限区域的诊断工具,可指导 flow matching 时间采样,减少冗余训练并提升生成质量。

共 50 条 · 按质量与时效综合排序 · 仅收录近 3 个月内容最近同步 56 分钟前
已折叠 · 展开查看该领域的技术路线图、最新技术与成果、发展态势与前景趋势(含表格与 Mermaid 路线图)。
提出 VAP:CIFAR-100 速度损失降 6.78%、FD 降 23.6%
提供可定位模糊受限/数据受限区域的诊断工具,可指导 flow matching 时间采样,减少冗余训练并提升生成质量。
提出 OmniCompass 基准:820 视频与 2,460 实例评测 50 个 MLLMs
统一全模态视频定位与理解评测,揭示开源模型在音视频理解上的差距,可用于多模态模型选型与诊断。

4B 的 GroundingPI 在 34 个 grounding 基准达 SOTA,超过 GPT-6 Astra
为 VLA/WAM 提供快速精确的视觉 grounding 基座,直接决定机器人闭环控制在杂乱场景与小目标上的可用性

Amazon Polly Generative 引擎升级:新增 14 个语音覆盖 9 个区域,Hindi/Finnish 正式可用
对使用 Polly 的 LLM 智能体语音应用,无需改代码即可获得更自然准确低延迟的语音,值得直接评估。
FreeVideo 可在 8GB VRAM、16GB RAM 上运行 MiniMax H3 生成视频
大幅降低视频生成本地推理的硬件门槛,使消费级设备即可运行 MiniMax H3,便于快速实验与部署。
DeepSeek 视觉工具箱支持图片问答、OCR与UI还原
为纯文本模型补齐视觉输入,适合 agent 截图/OCR/前端还原工作流。
NVIDIA Nemotron 3.5 VL 120B FP4 模型发布
NVIDIA 多模态大模型以 FP4/MoE 形态进入 transformers,可评估低精度视觉语言部署。

NVIDIA 开源 34B 推理视觉模型 Alpamayo 2 Super,可生成轨迹、推理链与自动标注
AV 开发长期因轨迹、意图、场景、标注各用独立模型而难以比对与复用;单一开源模型覆盖多环节,直接利好数据闭环工程。

VoiceStudio:本地开源语音克隆,支持 646 种语言
本地开源语音克隆与转录方案,可作为 ElevenLabs 替代评估起点。
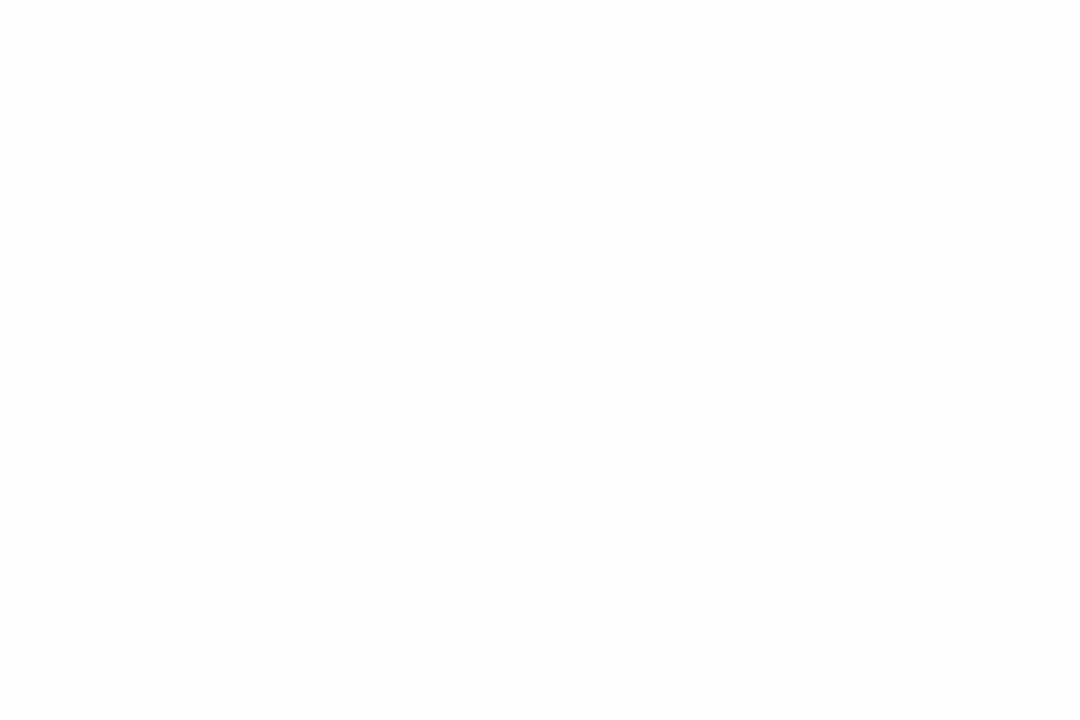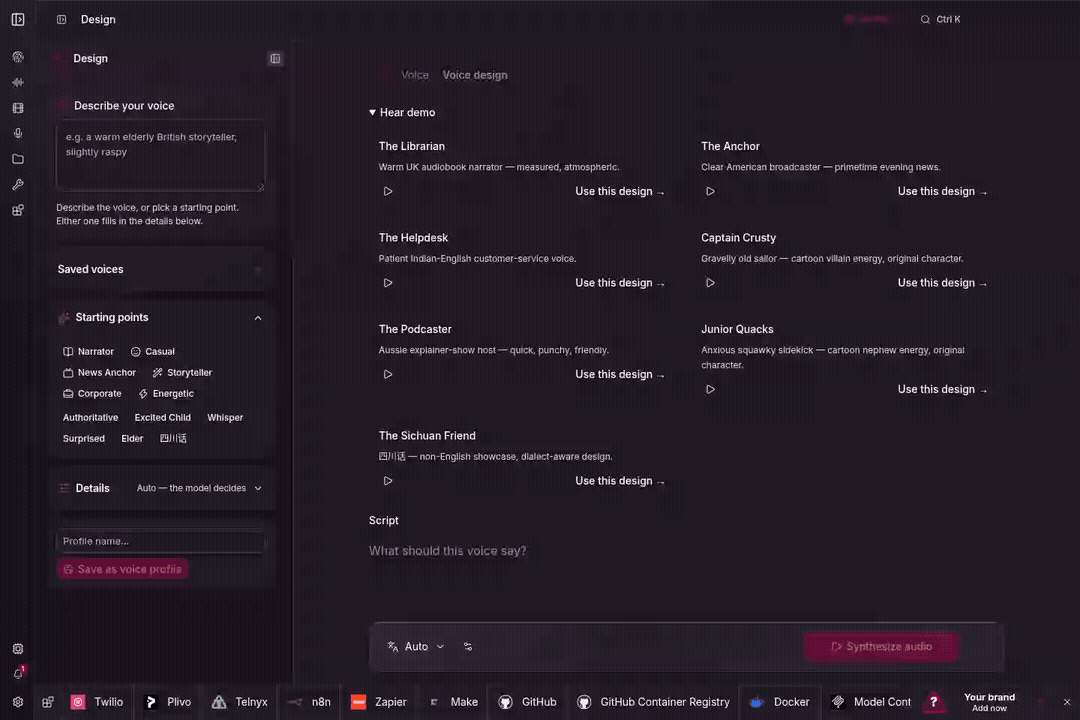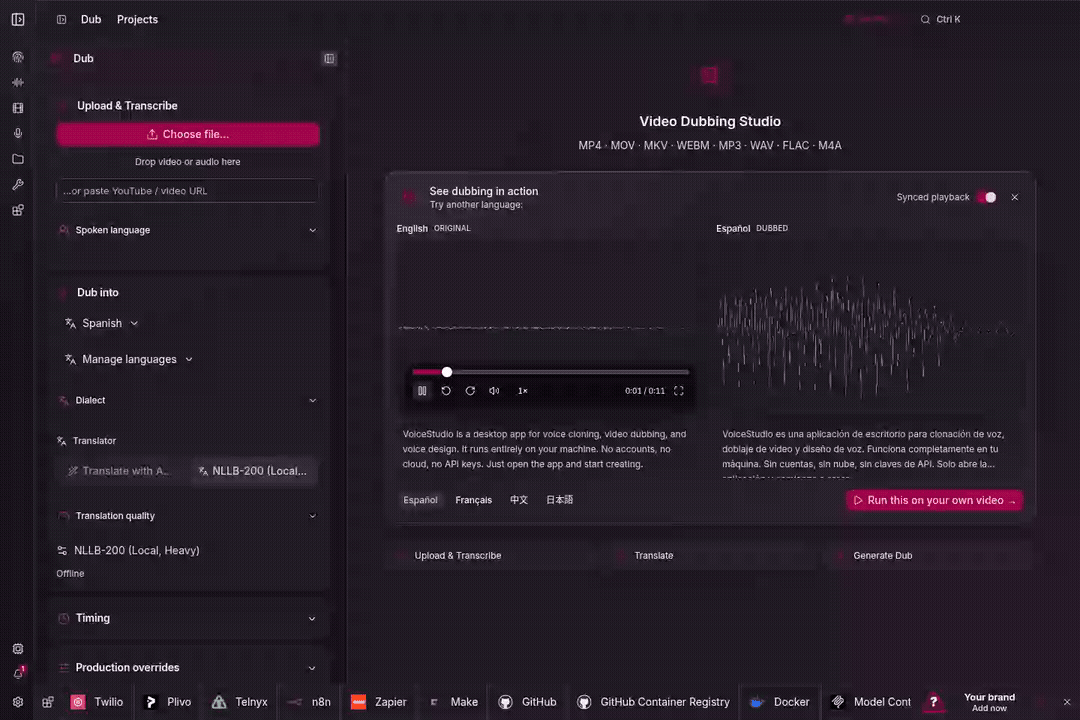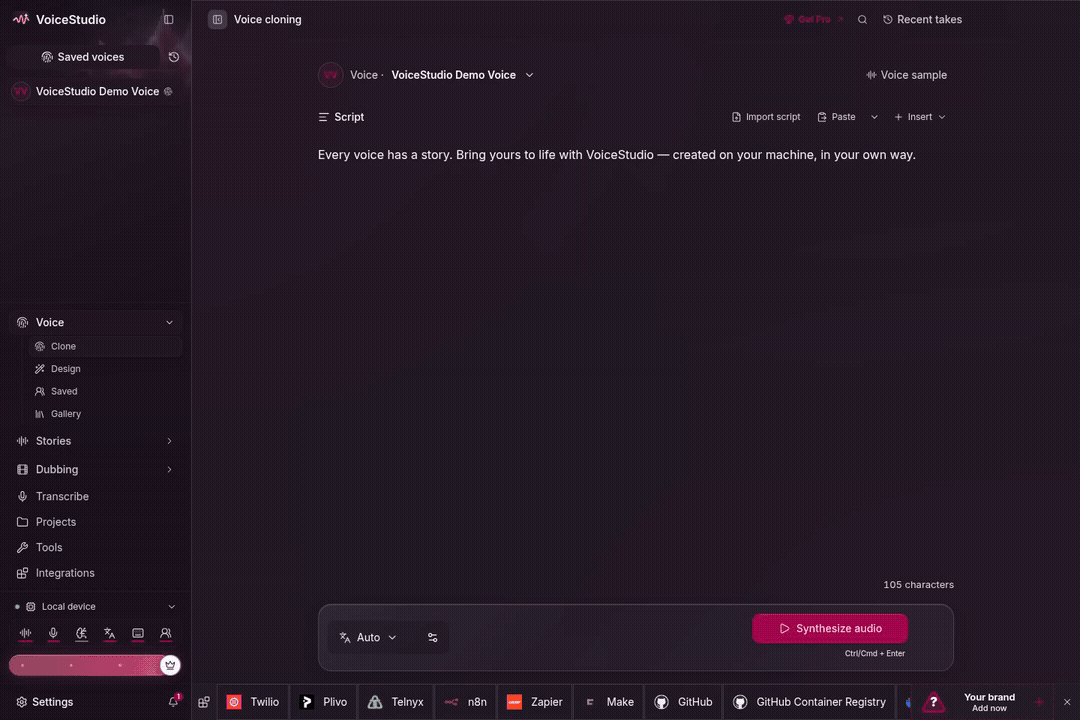
本地文件多模态搜索工具DigUp基于EmbeddingGemma 2
提供跨平台端侧检索实践,可评估用于数据闭环与知识管理。
agent-vision-toolkit 为纯文本模型补齐看图与 GUI 自动化
可让 Codex/Claude Code 等 Agent 低成本获得多图理解、长截图 OCR 与 GUI 操作能力
Kokoro-82M 流式 TTS 降低语音 agent 延迟
按句流式调用 Kokoro-82M TTS,避免等待完整响应,降低语音 agent 可感延迟与推理成本。