How NVIDIA OpenShell Reference Architecture Secures and Governs AI Agent Workloads at ScaleNVIDIA OpenShell 参考架构治理 AI agent 负载
NVIDIA OpenShell 参考架构治理 AI agent 负载
长时自主任务会下载代码、请求权限并扩大风险,参考架构可用于规模化治理。

资料 47 条 · 常规内容近 60–90 天,综述/报告保留一年最近同步 25 分钟前
NVIDIA OpenShell 参考架构治理 AI agent 负载
长时自主任务会下载代码、请求权限并扩大风险,参考架构可用于规模化治理。
8 个 DGX Spark 节点运行前沿 AI 模型,需 数百 GB 内存
展示桌面级 Spark 节点扩展运行大内存模型的路径,对本地多模型编排与硬件选型有参考。

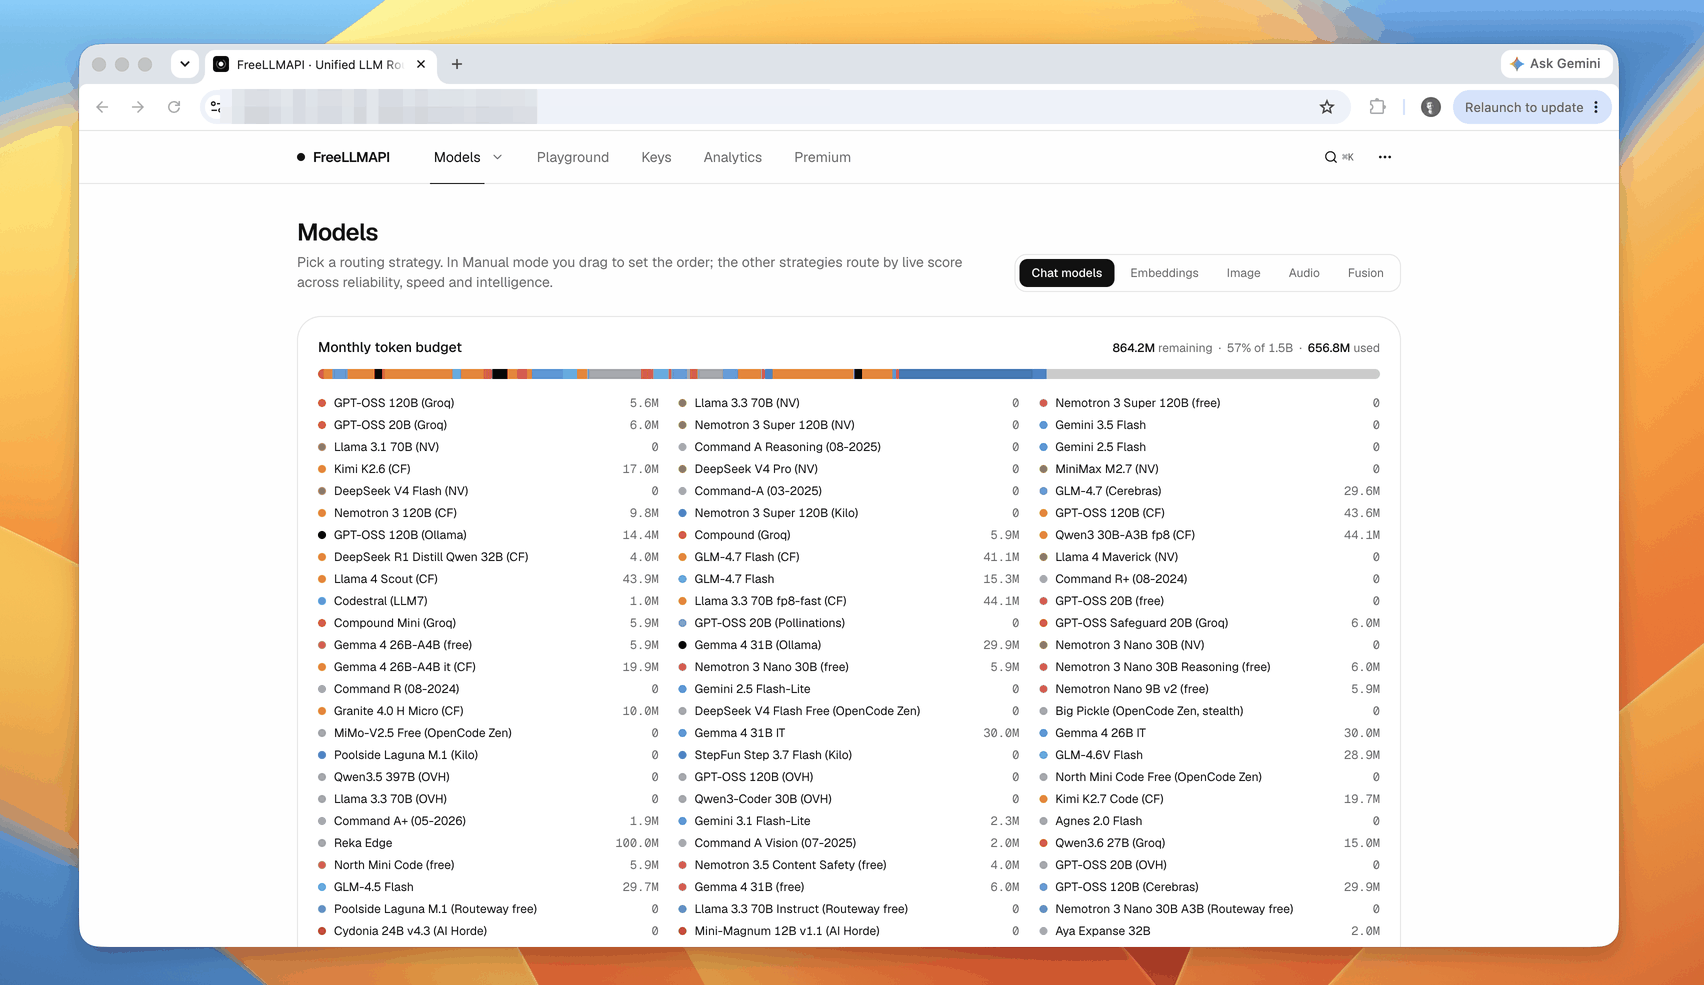
freellmapi 聚合 34 家免费 LLM 提供商
统一 /v1 端点并提供智能路由、自动故障转移与加密密钥,便于个人实验接入免费模型。
KTransformers v0.7.2 增加 DeepSeek-V4-Flash LoRA 微调,专家权重保持 MXFP4
使 DeepSeek-V4-Flash 可在 CPU+GPU 异构环境做 LoRA 微调,原生 MXFP4 前后向避免 BF16 展开专家权重,降低显存/内存开销,并集成 LLaMA-Factory SFT 流程。
TensorRT 详解引擎构建中的调度:图变换、融合、量化等决策相互耦合
讲清 TensorRT 引擎构建中调度的本质与耦合决策,是推理性能优化的基础背景。

Ai2 新 GPU 调度器:以时间预算、公平份额与时间片缩短排队、保持 GPU 忙碌
对自管 GPU 集群的调度与利用率优化有直接参考价值,可借鉴其优先级设计。
Triton 3.8.0 发布:aggregate 成公共 API,含破坏性变更
LLM GPU kernel 核心工具的功能版本,自写 Triton kernel 的团队需核对破坏性变更
Ollama v0.40.7新增27Bpplx-decider决策模型
对使用 Ollama 本地推理的工程师,提升 OpenAI 兼容 Responses 稳定性,新增 27B 决策模型与更自动的推测解码支持。
TorchNeuron 让在 AWS Trainium 上运行 HF 模型比以往更容易
信息不足,影响待观察

SGLang 面向 LLM 与多模态的高性能 serving 框架
信息不足,影响待观察
Colibri 用纯 C 零依赖运行前沿 MoE 模型
提出磁盘流式加载专家的轻量 MoE 推理思路,但材料过少,工程成熟度待观察。